Documentos y datos
Convertir JSON anidado a CSV: cómo aplanar datos sin perder su significado
Aprende a elegir nodos de fila, aplanar objetos y definir reglas para arrays. Sigue ejemplos conceptuales, compara posibles estructuras y revisa la vista previa del CSV.
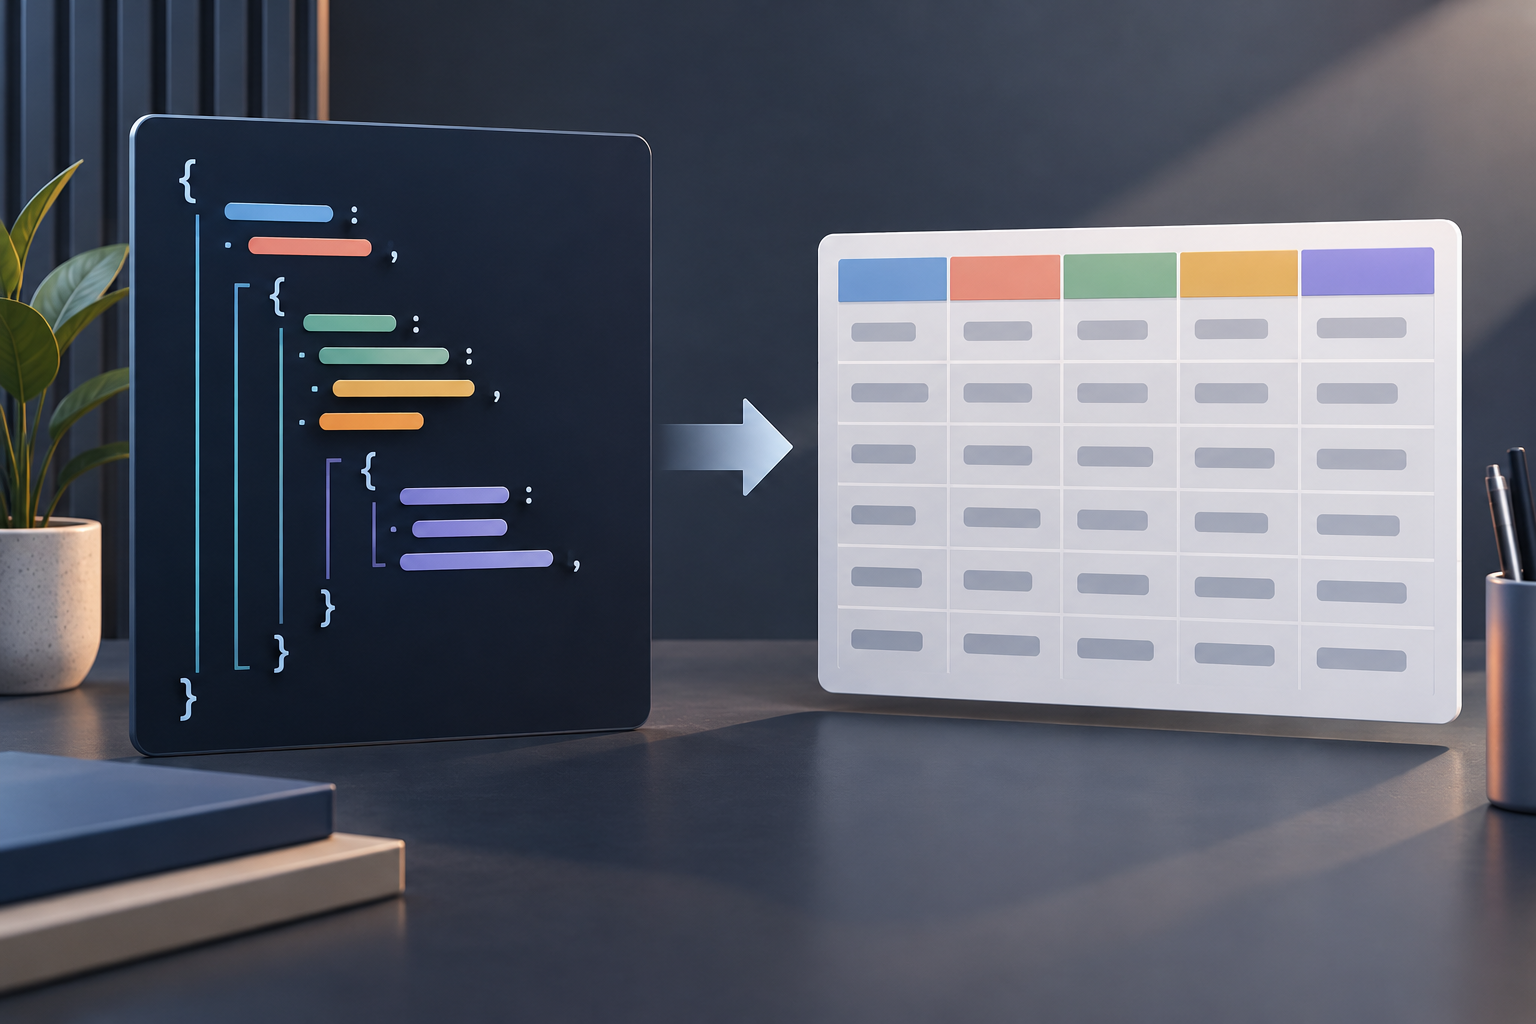
Qué hay que decidir al convertir JSON anidado a CSV
JSON puede contener objetos anidados y arrays; CSV organiza la información en filas y columnas. Al pasar de una estructura a otra, necesitas decidir qué elemento representa una fila y qué campos se convertirán en columnas. La conversión no consiste únicamente en cambiar la extensión: también implica elegir cómo representar los datos que no encajan directamente en una tabla plana.
La herramienta de Datablist permite seleccionar nodos de fila, elegir objetos para aplanar, definir reglas para arrays y previsualizar el CSV antes de descargarlo. Estas funciones permiten configurar la conversión, pero el resultado concreto depende de las elecciones que hagas. No des por sentados los nombres de las columnas ni la representación de cada campo sin revisar la configuración y la vista previa.
Antes de empezar, observa la estructura del JSON y localiza el objeto o conjunto de objetos que contiene los registros de interés. Después identifica qué información necesitas en la tabla final. Un archivo puede incluir campos que no te hacen falta para el propósito de la exportación; decidir qué conservar es una parte práctica del diseño, no una propiedad automática del formato CSV.
- Decide qué nodo del JSON representa cada fila.
- Elige qué objetos anidados quieres aplanar.
- Define una regla para los arrays y revisa la vista previa.
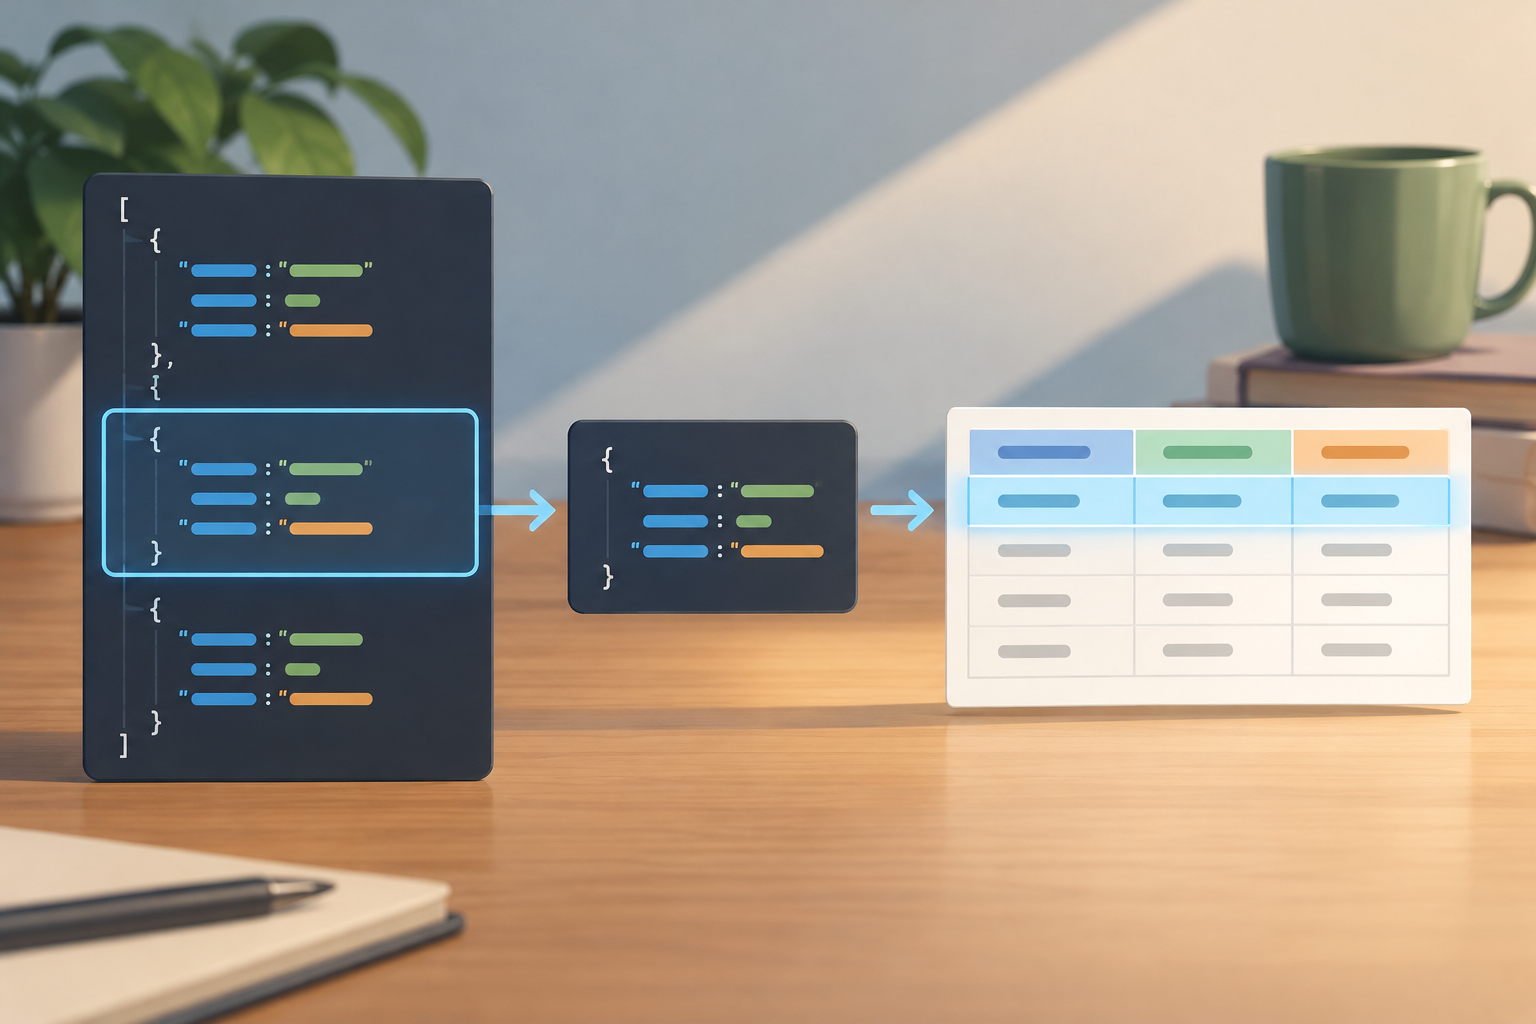
Ejemplo: aplanar un objeto anidado
Considera este ejemplo hipotético, en el que cada pedido representa una fila y los campos del objeto «cliente» se convierten en columnas. La entrada contiene un solo pedido para que se vea con claridad qué significa aplanar un objeto: elegir campos que están dentro de otro objeto y representarlos como columnas de la tabla.
JSON de entrada: {"pedido_id": "P-104", "cliente": {"nombre": "Lucía", "ciudad": "Sevilla"}, "total": 48.5}
Una posible representación CSV para esa decisión es: pedido_id,cliente_nombre,cliente_ciudad,total P-104,Lucía,Sevilla,48.5
En esta propuesta, cliente_nombre y cliente_ciudad expresan qué campos del objeto cliente se han llevado a la tabla. Los nombres son ilustrativos: no son una convención que las fuentes citadas atribuyan a Datablist ni una garantía sobre cómo otra herramienta nombrará las columnas. Si necesitas encabezados con un formato específico, compruébalos en la previsualización.
La decisión cambia qué resulta fácil de consultar en la tabla. Si aplanas los campos que necesitas, puedes verlos como columnas separadas; si eliges otra estructura o dejas un objeto sin aplanar, la representación puede no coincidir con la tabla que esperabas. Por eso conviene comparar los encabezados y los valores de la vista previa con los campos originales, en lugar de asumir que el ejemplo determina el resultado de tu conversión.
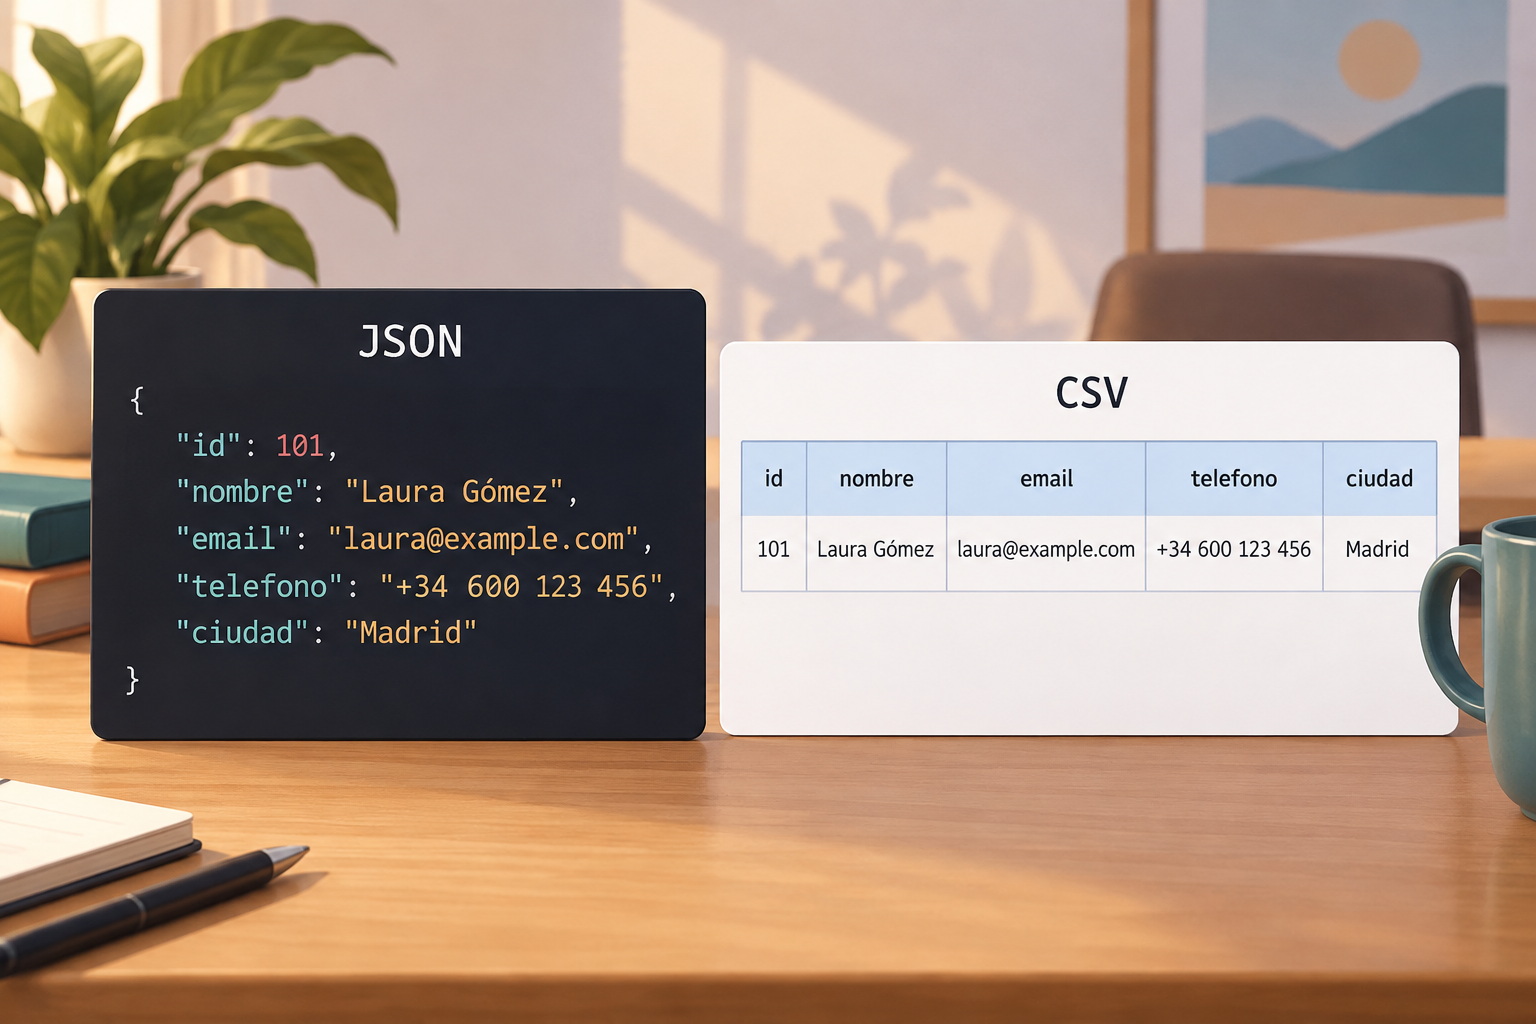
Cómo pensar en arrays: dos representaciones posibles
Los arrays requieren una regla de conversión. Datablist indica que su conversor permite definir reglas para arrays, pero la evidencia disponible no especifica cómo resuelve casos concretos, como arrays de distinta longitud o arrays vacíos. El siguiente ejemplo es un modelo conceptual para mostrar por qué conviene decidir la forma tabular; no describe opciones ni resultados garantizados de Datablist.
Supongamos que un pedido contiene dos etiquetas: «urgente» y «regalo». Una representación ilustrativa podría reservar columnas por posición, como etiqueta_1 y etiqueta_2, y mantener el pedido en una fila. Otra representación conceptual podría dedicar una fila a cada etiqueta, repitiendo el identificador del pedido: P-104 con «urgente» en una fila y P-104 con «regalo» en otra. Ninguna de estas muestras afirma que el conversor genere esas estructuras automáticamente.
Estas alternativas tienen consecuencias visibles. Una fila con columnas por posición mantiene juntos los datos del pedido en el ejemplo, pero si otro registro tiene más elementos que las posiciones representadas habría que decidir cómo acomodarlos. Una fila por elemento permite mostrar cada etiqueta por separado en la muestra, pero repite el dato que identifica el pedido. Son consecuencias del diseño de esas tablas hipotéticas, no una descripción del comportamiento de una herramienta concreta.
Al configurar una conversión real, no supongas cuál de estas formas —u otra— produce la regla disponible. Revisa la vista previa con un ejemplo que incluya un array con elementos y compárala con el JSON de origen. Si los arrays de tus datos varían, incluye más de un caso en la comprobación. La evidencia citada no documenta cómo se resuelven arrays vacíos, campos ausentes o valores nulos; para esos casos, verifica el resultado con la configuración elegida.
- Trata las representaciones del ejemplo como esquemas posibles, no como resultados atribuidos a Datablist.
- Comprueba la vista previa con arrays representativos de tus datos.
- Verifica por separado los casos que la documentación disponible no especifica.
Métodos mencionados para convertir JSON a CSV en Python
Bright Data menciona las bibliotecas csv, json y pandas como métodos para convertir datos JSON a CSV en Python, y señala que cada método tiene ventajas. La evidencia disponible aquí no detalla esas diferencias ni prescribe una implementación concreta, así que no basta para afirmar que una biblioteca sea la mejor para una estructura determinada.
Al elegir un método, empieza por describir la estructura del archivo y el resultado tabular que necesitas: qué elemento será una fila, qué campos deben convertirse en columnas y qué decisión has tomado para los arrays. Luego consulta la documentación del método para confirmar sus opciones y su comportamiento con esa estructura.
No asumas que una regla de un conversor visual se aplica igual a una biblioteca de Python, ni que los tres nombres citados implican idénticos resultados. Si comparas métodos, utiliza el mismo JSON de prueba y revisa las tablas producidas con los mismos criterios. Esa comparación te ayuda a detectar si los encabezados y las filas corresponden a la estructura que buscabas, sin atribuir capacidades específicas que las fuentes disponibles no confirman.
Previsualizar y revisar la conversión
La previsualización forma parte de las opciones descritas para el conversor de Datablist. Úsala para comprobar si la selección de nodos, el aplanado de objetos y las reglas para arrays producen una tabla coherente con lo que esperabas antes de descargar el CSV. La revisión no sustituye una definición clara de la estructura: permite comparar el resultado visible con tus decisiones.
Una comprobación útil consiste en seguir uno o varios registros desde el JSON hasta la vista previa. Busca el valor original, comprueba qué fila y columna lo representan y revisa que los encabezados expresen los campos que querías incluir. Para un objeto anidado, comprueba los campos que aplanaste; para un array, observa la representación efectiva sin inferirla a partir de un ejemplo distinto.
Si el resultado no conserva la estructura que esperabas, vuelve a las decisiones iniciales: quizá seleccionaste un nodo de fila distinto, no elegiste aplanar el objeto pertinente o la regla del array no produce la forma que tenías en mente. Si aparecen campos ausentes o valores nulos, no des por hecho cómo los interpreta la herramienta: la evidencia disponible no documenta ese comportamiento. Verifica esos casos con la configuración seleccionada antes de usar el archivo.
Para mantener organizados el original y los resultados de trabajo, Apification Cloud ofrece un espacio de trabajo versionado y permite revisar el historial de elementos. Esto puede ayudar a localizar versiones de archivos de trabajo; no valida la conversión ni sustituye la revisión del contenido del CSV.
- Comprueba los encabezados y sigue algunos valores desde el JSON hasta la vista previa.
- Incluye en la revisión objetos anidados y arrays que representen la estructura real de tus datos.
- Si el resultado no coincide con lo esperado, revisa la selección y la regla antes de descargar.
- Conserva localizable el JSON de origen y el CSV de trabajo.
Fuentes técnicas consultadas
Datablist, «Convertidor de JSON a CSV»: https://www.datablist.com/es/tools/json-to-csv. La evidencia disponible describe la selección de nodos de fila, el aplanado de objetos, las reglas para arrays y la previsualización antes de descargar.
Bright Data, «¿Cómo convertir datos JSON a CSV en Python?»: https://brightdata.es/faqs/json/convert-json-data-to-csv. La evidencia disponible menciona las bibliotecas csv, json y pandas.
Los ejemplos de tablas de esta guía son ilustrativos. Las fuentes citadas no documentan una convención específica para nombrar columnas ni el tratamiento exacto de arrays de distintas longitudes, arrays vacíos, campos ausentes o valores nulos.
Preguntas frecuentes
¿Qué debo decidir antes de convertir JSON anidado a CSV?
Define qué nodo representa una fila, qué objetos quieres aplanar y qué regla usarás para los arrays. Datablist ofrece opciones para esas decisiones y una vista previa del CSV.
¿Cómo se representa un objeto anidado en CSV?
Puedes elegir aplanar sus campos en columnas. Por ejemplo, en una representación ilustrativa, los campos cliente.nombre y cliente.ciudad pueden aparecer como cliente_nombre y cliente_ciudad.
¿Cómo debo tratar arrays de distinta longitud o valores nulos?
La evidencia técnica disponible no especifica el comportamiento de cada conversor para esos casos. Comprueba la configuración y la vista previa con datos que incluyan los casos presentes en tu archivo.
¿Qué bibliotecas de Python se mencionan para convertir JSON a CSV?
Bright Data menciona csv, json y pandas. Consulta la documentación del método elegido para conocer sus opciones y su comportamiento con tu estructura de datos.
Fuentes y lecturas
Documentación consultada para elaborar este artículo.
- Convertidor de JSON a CSV — Datablist
- ¿Cómo convertir datos JSON a CSV en Python? — Bright Data
Explora Apification
Artículos relacionados
Documentos y datos
Unir PDF con formularios interactivos: cómo comprobar los campos antes de compartir
Una guía operativa para identificar campos rellenables, preparar los archivos, combinar copias y probar el resultado antes de distribuirlo.
Documentos y datos
Fuentes sustituidas en un documento: cómo detectar cambios de diseño y preparar una entrega fiable
Una guía práctica para investigar avisos de fuentes, comparar la maquetación y decidir qué archivos entregar sin perder el original editable.
Documentos y datos
Cómo compartir una hoja de cálculo editable sin romper fórmulas ni reportes
Organiza la captura, los cálculos y los reportes antes de compartir una hoja. Aprende a coordinar cambios, probar fórmulas y recuperar una versión anterior si algo falla.