API y automatización
Errores en una API de archivos: cómo diagnosticarlos sin exponer datos ni repetir acciones a ciegas
Una guía práctica para localizar en qué etapa falla una integración de archivos, registrar información útil sin revelar datos sensibles y decidir si corregir, reintentar o detener una operación.
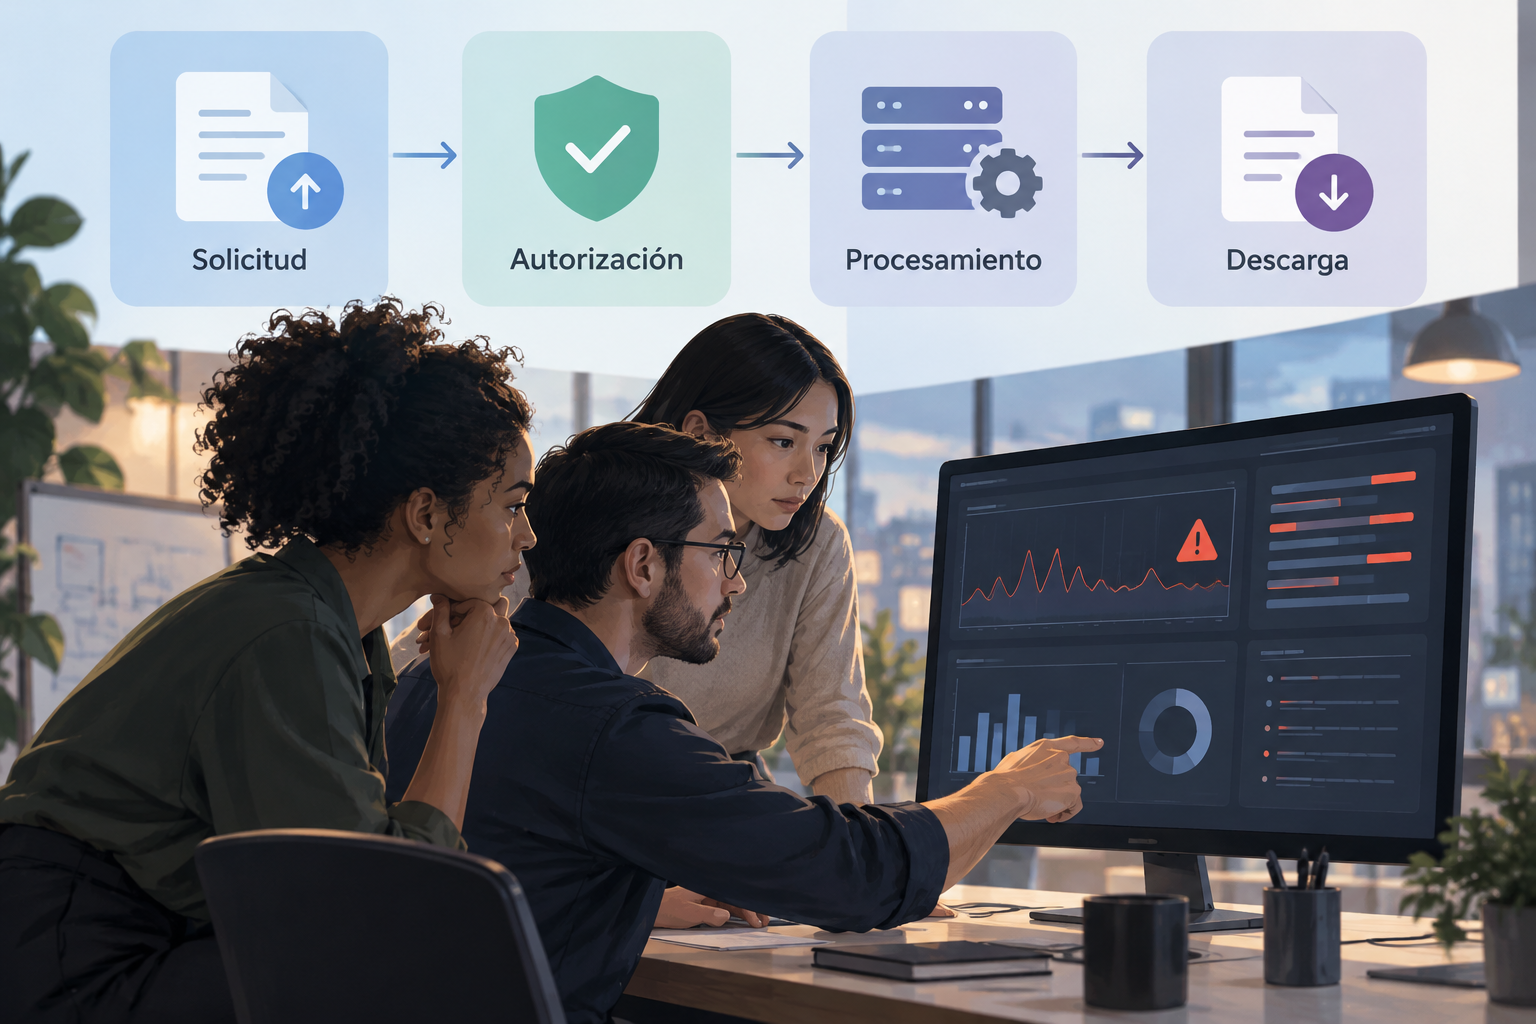
Por qué «falló la carga» no basta para diagnosticar
Un aviso genérico confirma que algo no terminó como se esperaba, pero no indica dónde investigar. El archivo pudo no llegar a enviarse, la identidad de la integración pudo carecer de acceso, el procesamiento pudo fallar o la respuesta pudo haberse generado sin que el cliente lograra descargarla. Si todas esas situaciones terminan en el mismo mensaje, el equipo prueba soluciones al azar y puede repetir operaciones que ya tuvieron efecto.
Diseña el diagnóstico para responder tres preguntas: qué acción se intentó, en qué etapa se interrumpió y qué evidencia permite confirmarlo. Por ejemplo, registra que una solicitud de transformación llegó a la etapa de procesamiento y que el resultado no pudo recuperarse, sin guardar el contenido del archivo. Esa descripción orienta mejor que «error», pero no promete una causa que todavía no se ha verificado. El objetivo inicial es acotar el problema, no adivinarlo.
- Sustituye «falló la carga» por una descripción de la etapa y el tipo de acción.
- Separa los hechos observados de las hipótesis sobre la causa.
- No conviertas el texto visible al usuario en el único registro para soporte.
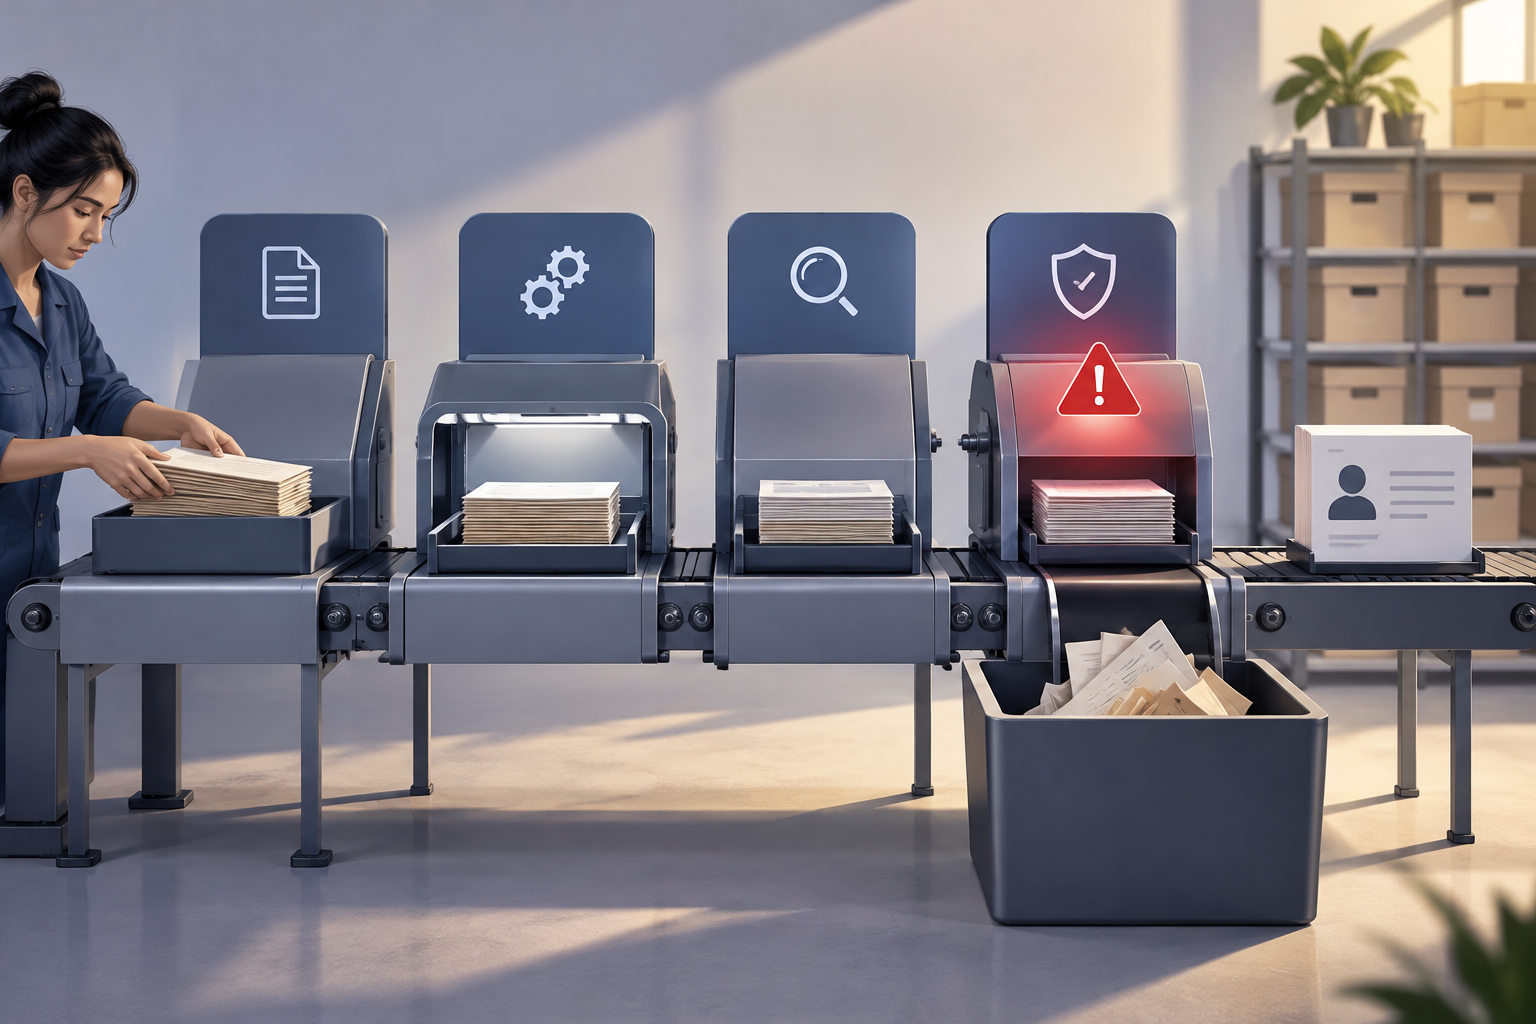
Separa el flujo en etapas antes de buscar la causa
Divide el recorrido en solicitud, autorización, procesamiento y entrega. En la solicitud, verifica que tu aplicación construya la petición con los campos que exige el contrato, y que el archivo y las opciones correspondan a lo esperado. En autorización, comprueba qué identidad se utiliza y si tiene acceso a la operación y al recurso. No confundas una petición mal formada con una falta de permiso: son investigaciones distintas.
Después, distingue el procesamiento de la entrega. Una transformación puede no completarse; también puede existir un resultado que el cliente no consiga recuperar o descargar. Registra el último hito confirmado y el siguiente que no pudo verificarse. Si Apification forma parte del flujo, sus servicios se integran mediante API REST, OpenAPI y webhooks; consulta la documentación aplicable para entender qué señales expone cada interfaz, en vez de dar por hecho que todas informan igual.
- Anota etapa, operación y hora de inicio y fin con una referencia interna no sensible.
- Identifica qué componente confirmó el último hito y cuál debía actuar después.
- Prueba cada tramo por separado cuando el diseño de la integración lo permita.
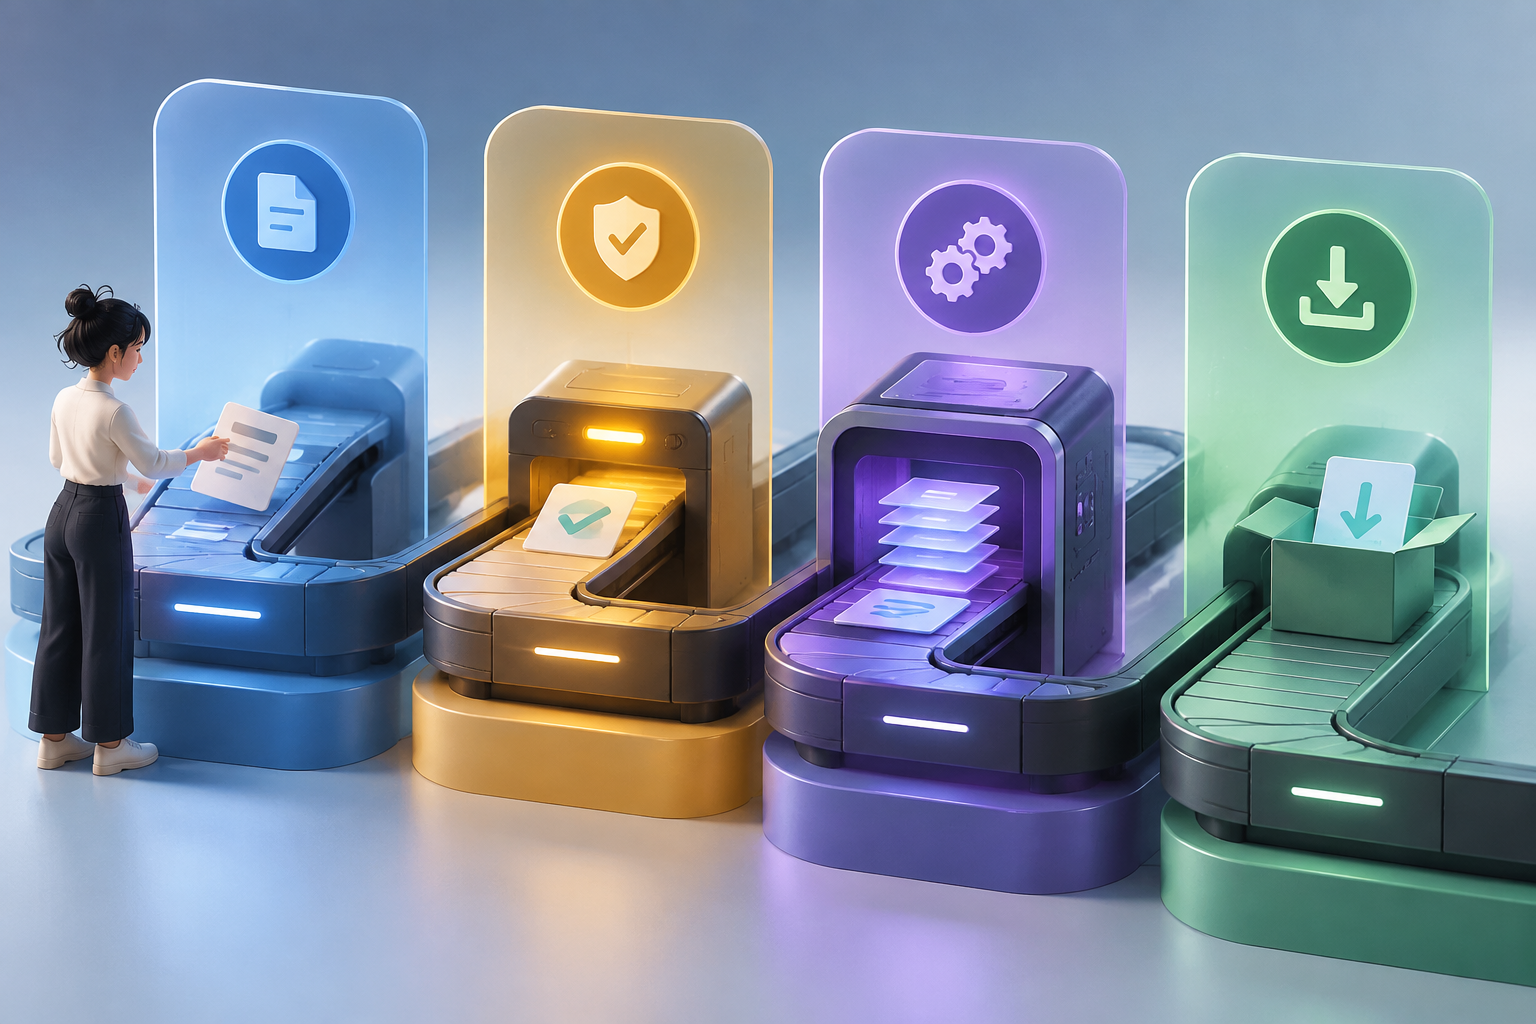
Clasifica el fallo antes de cambiar o repetir la operación
Una clasificación sencilla evita mezclar problemas diferentes. Considera al menos: entrada inválida o incompleta; permiso insuficiente; dependencia temporalmente inaccesible; y resultado incierto, cuando no puedes confirmar si la operación produjo cambios. Añade una categoría distinta para fallos de entrega. Son grupos de investigación, no códigos universales: una API concreta puede usar otros nombres, estados o distinciones, que debes comprobar en su documentación.
Relaciona cada clase con una comprobación, no con una acción automática. Para una entrada, valida el formato y los campos requeridos antes de enviar. Para permisos, verifica identidad, ámbito y acceso efectivo al recurso. Ante una dependencia temporal, comprueba si hay evidencia de recuperación antes de decidir el siguiente paso. Si el resultado es incierto, detén la repetición hasta poder reconciliar el estado. Así se evita tratar cualquier error como transitorio o culpar a permisos sin evidencia.
- Registra categoría provisional y nivel de confianza; actualízalos cuando aparezcan pruebas.
- Mantén «causa desconocida» como opción válida.
- No deduzcas la clase de fallo solo por una frase breve de respuesta.
Mensajes útiles y registros seguros cumplen funciones distintas
El mensaje para quien opera debe explicar qué puede hacer ahora: revisar los datos, solicitar acceso o contactar con soporte con una referencia de incidente. Evita mostrar detalles internos, rutas privadas, contenido del archivo, credenciales o trazas completas. La persona necesita una instrucción comprensible, no la respuesta técnica sin filtrar. Si aún no se conoce la causa, dilo con claridad en lugar de atribuir el problema a un permiso o a una avería.
El registro técnico necesita contexto suficiente para reconstruir el recorrido, pero no el archivo en sí. Un ejemplo seguro podría incluir: fecha y hora, acción «transformar», etapa «entrega», entorno, resultado observado y referencia opaca de correlación. No incluyas tokens, claves, datos personales innecesarios, nombres de archivo sensibles ni cuerpos completos de peticiones. Define quién puede consultar los registros y durante cuánto tiempo se conservan conforme a las reglas de tu organización.
- Ejemplo de registro: «acción=transformar; etapa=entrega; referencia=opaca; resultado=no_confirmado».
- Elimina o enmascara secretos y datos que no sean necesarios para el diagnóstico.
- Comprueba que mensajes, trazas y herramientas de soporte no filtren el mismo dato por otra vía.
Interpreta estados y errores según el contrato de la API
No hay una tabla universal de errores que puedas aplicar a cualquier API. La documentación de Google para su API de Indexing identifica códigos y mensajes propios de ese servicio; no convierte esas respuestas en reglas para una API de archivos. Del mismo modo, una guía de solución de problemas de una API específica ayuda a interpretar esa API, no a inferir cómo responde otra. Usa esos recursos como ejemplo de por qué cada integración requiere consultar su fuente primaria.
Antes de implementar decisiones automáticas, localiza en el contrato qué operaciones existen, qué entradas requieren y cómo se describen sus resultados y errores. Verifica también si la documentación establece condiciones de repetición o identificación de solicitudes. Si el contrato no resuelve una duda, no inventes un significado a partir del texto del error: conserva la evidencia, evita acciones arriesgadas y consulta al responsable del servicio. Documenta la versión o referencia del contrato que utilizó el equipo.
- Consulta la documentación oficial de la API concreta y la operación concreta.
- Comprueba si estados, mensajes y condiciones de reintento están definidos para esa operación.
- Trata cualquier mapeo local de errores como una interpretación documentada y revisable.
Decide entre corregir, reintentar o detenerte
Corrige cuando la evidencia señale una entrada incorrecta o un permiso que deba ajustarse; después, valida el cambio antes de enviar de nuevo. Un reintento solo es razonable cuando la documentación y el estado observado permiten hacerlo con seguridad. Si la API documenta mecanismos para identificar solicitudes repetidas o consultar el resultado previo, incorpóralos. No supongas que una operación es idempotente ni que un fallo de comunicación significa que el servidor no actuó.
Detente cuando el resultado sea incierto, cuando repetir pueda duplicar una conversión, publicación o cambio, o cuando exista un riesgo de acceso indebido. Conserva la referencia del intento y busca confirmar el estado antes de iniciar otra acción. Si la API documenta reintentos para webhooks o acciones concretas, respeta esas condiciones; no las extrapoles a otros endpoints. En Apification, las automatizaciones mediante API y webhooks incluyen reintentos, historial y estadísticas, pero la integración debe seguir el comportamiento documentado para cada acción.
- Corregir: hay una causa verificable en los datos o permisos.
- Reintentar: el contrato lo permite y el estado previo está suficientemente claro.
- Detener: la operación podría haberse aplicado y no puedes confirmar el resultado.
Prueba fallos y reconstruye incidentes con evidencia
Incluye pruebas negativas además del recorrido correcto. Comprueba qué sucede con una entrada incompleta, una identidad sin el permiso necesario, una dependencia temporalmente no disponible y una descarga que no se completa. Para cada caso, verifica el mensaje mostrado, la información registrada y la decisión tomada por el cliente. Los casos deben ajustarse a lo que realmente permite simular el entorno de pruebas; no fuerces operaciones que puedan afectar archivos de producción.
Una prueba útil permite reconstruir la secuencia sin exponer el contenido: solicitud iniciada, etapa alcanzada, error observado, decisión automática o manual y estado final confirmado. Revisa que dos intentos relacionados puedan distinguirse y que las referencias no revelen identificadores internos a usuarios no autorizados. Si se utilizan versiones de archivos, Apification Cloud permite consultar el historial, descargar versiones anteriores y restaurar contenido; esa capacidad puede ayudar a recuperar un estado anterior, pero no sustituye la verificación de qué operación falló.
- Prueba fallos de entrada, acceso, procesamiento y entrega por separado.
- Verifica que no se repitan acciones sin una decisión explícita y trazable.
- Comprueba que el equipo pueda seguir el incidente sin consultar secretos ni contenido sensible.
Checklist para una integración diagnosticable y segura
Antes de publicar una integración, confirma que cada operación tenga una etapa identificable y que el cliente distinga una corrección de una repetición. Asegúrate de que el contrato oficial esté disponible para quienes mantienen el código y de que las decisiones automáticas tengan una justificación documentada. Revisa también los permisos con los que actúa la integración: conceder más acceso del necesario puede convertir un problema de configuración en una exposición de archivos.
Finalmente, ensaya el procedimiento de soporte con un incidente de prueba. Una persona debe poder explicar qué se intentó, qué se confirmó, qué sigue siendo incierto y cuál es el próximo paso seguro, usando solo registros permitidos. Apification ofrece capacidades de gestión y compartición de archivos en Cloud y opciones de integración; la seguridad del flujo concreto depende también de cómo configures permisos, controles y tratamiento de errores. Mantén el checklist actualizado cuando cambie el contrato o el recorrido.
- Cada error identifica la etapa y una referencia de correlación no sensible.
- Los mensajes de usuario orientan sin revelar detalles internos.
- Los registros omiten credenciales, contenido y datos personales innecesarios.
- Los códigos y estados se interpretan con la documentación de la API concreta.
- Los reintentos están condicionados al contrato y a la certeza sobre el resultado.
- Los casos de error se prueban y el equipo puede reconstruir un incidente.
Preguntas frecuentes
¿Puedo usar los mismos códigos de error para todas las API de archivos?
No. Los códigos, mensajes y significados dependen de la API y de la operación. Consulta el contrato y la documentación oficial del servicio integrado; no extrapoles la tabla de una API distinta.
¿Cuándo conviene reintentar una operación de archivo?
Solo cuando la documentación aplicable permita repetirla y puedas valorar el estado del intento anterior. Si no sabes si el archivo ya se procesó o cambió, detente y confirma el resultado antes de volver a actuar.
¿Qué datos debería contener un registro de error seguro?
Incluye el tipo de acción, la etapa, una marca temporal, el resultado observado y una referencia de correlación que no exponga información interna. Excluye credenciales, contenido del archivo y datos personales que no sean necesarios.
Fuentes y lecturas
Documentación consultada para elaborar este artículo.
- Lista de errores de la API de Indexing — Google for Developers
- Solucionar problemas de la API multivariante — Microsoft Learn
- Solución de errores y latencia de la API — OpenAI Help Center
Explora Apification
Artículos relacionados
API y automatización
Cómo rotar credenciales de una API sin dejar una integración de archivos a medias
Una guía para preparar, desplegar, verificar y retirar credenciales de API con controles que reducen el riesgo de interrumpir los flujos de archivos.
API y automatización
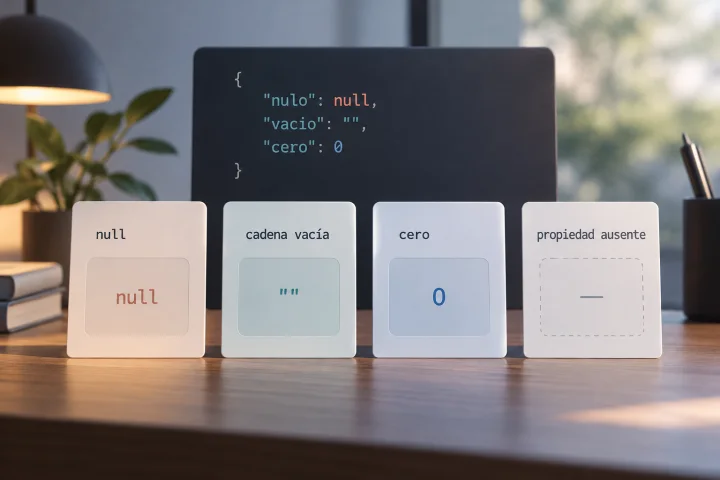
Null, vacío, cero o campo ausente: cómo evitar cambios de significado en JSON para una API
Distingue los valores de un payload JSON y consulta el contrato de la API antes de decidir cómo transformar o enviar cada uno.
API y automatización
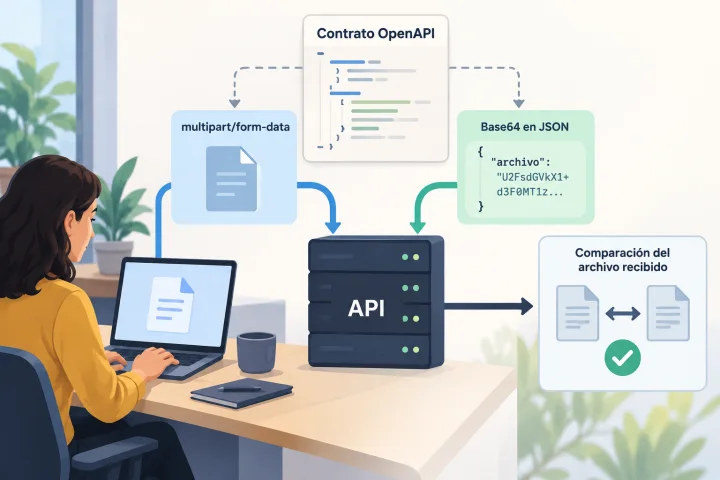
Enviar archivos a una API: multipart o Base64 y cómo evitar cargas dañadas
La representación correcta depende del contrato de cada endpoint. Aprende a inspeccionarlo, construir solicitudes compatibles y verificar el archivo recibido antes de poner la integración en producción.