API et automatisation
Comment identifier les fichiers dans une API sans dépendre de noms ou de chemins susceptibles de changer
Concevez des références moins sensibles aux renommages et aux déplacements : examinez le contrat OpenAPI, conservez les correspondances et testez les cas susceptibles de rompre la synchronisation.
Pourquoi le nom ou le chemin peuvent rompre une intégration
Utiliser le chemin complet comme clé semble simple : il permet de localiser un fichier et se lit facilement dans les journaux. Mais un chemin décrit l’emplacement de la ressource, pas nécessairement son identité. Si quelqu’un réorganise les dossiers ou renomme le fichier, une référence enregistrée dans un autre système risque de ne plus permettre de le retrouver. Un processus de synchronisation pourrait alors interpréter ce changement comme la disparition d’un fichier et l’apparition d’un autre.
Le nom seul est encore plus ambigu : plusieurs fichiers peuvent porter le même nom, qui peut aussi changer à la suite d’une correction, de l’adoption d’une nouvelle convention ou d’une action de l’utilisateur. Ne partez pas du principe qu’une API préserve l’identité d’un fichier lorsqu’il est déplacé ou renommé. L’opération de renommage d’Azure Storage documentée par Microsoft (https://learn.microsoft.com/es-es/rest/api/storageservices/rename-file) permet de changer le nom, mais cette information ne définit pas, à elle seule, les garanties d’identité offertes par tous les services. Il faut vérifier le contrat concerné.
- Considérez le nom et le chemin comme des attributs descriptifs susceptibles de changer.
- Avant de synchroniser, identifiez la ressource mise à jour et les éléments qui permettent de la reconnaître.
Distinguer nom, chemin et identifiants
Dans le modèle d’intégration, il est utile de distinguer quatre notions. Le nom visible est l’étiquette du fichier ; le chemin décrit son emplacement dans une structure ; l’identifiant de la ressource est la valeur que l’API documente pour désigner cette ressource ; et l’identifiant externe est celui qu’utilise un autre système, comme un registre métier ou une application cliente. Sans documentation, le fait qu’un champ s’appelle id ne prouve ni sa portée ni sa durée de validité.
Certains identifiants peuvent être limités à un compte, un espace de travail ou un service. La clé interne de votre intégration peut donc se composer du fournisseur, du périmètre du compte et de l’identifiant documenté, plutôt que de supposer que cette valeur est unique à l’échelle mondiale. Enregistrez le nom et le chemin comme données auxiliaires pour l’affichage, la recherche ou le diagnostic. N’en faites pas l’identité du fichier si le service ne garantit pas qu’ils sont uniques et immuables.
- Vérifiez dans quel périmètre l’identifiant est unique et ce qui se passe lorsque le fichier est déplacé, copié ou recréé.
- Distinguez une copie de la même ressource d’une nouvelle version ; ne présumez pas de la manière dont l’API les définit.
Examiner chaque opération OpenAPI
Commencez par la spécification OpenAPI correspondant à la version réellement utilisée par votre intégration. Repérez les opérations de liste, de consultation, de création, de mise à jour, de déplacement et de suppression, si elles existent. Pour chacune, examinez les paramètres de chemin et de requête, le corps de la requête, les réponses et les schémas réutilisés. Notez le nom et le type de chaque champ susceptible d’être un identifiant, les endroits où il apparaît et si une réponse de création le renvoie. Ne déduisez pas le comportement d’un point de terminaison du seul nom du champ.
Comparez ensuite le contrat à la documentation descriptive et, dans un environnement de test, à des réponses réelles ne contenant pas de données sensibles. Vérifiez si une opération attend un identifiant ou un chemin, si elle renvoie les deux et si les recherches acceptent des filtres. Google Drive documente plusieurs façons de rechercher des fichiers et des dossiers et mentionne la méthode list (https://developers.google.com/workspace/drive/api/guides/search-files?hl=es-419) ; cela ne permet pas de généraliser ses champs ou ses garanties à un autre service. Apification propose une intégration via REST API et OpenAPI, mais les garanties d’identité doivent être confirmées dans la documentation de chaque opération.
- Consignez la version de la spécification, l’opération, le champ, le type, le périmètre et les éléments attestant le comportement.
- Si le contrat ne documente ni la stabilité ni le cycle de vie, indiquez que la garantie est inconnue et demandez des précisions au fournisseur.
Tenir une table de correspondance explicite
Après avoir confirmé l’identifiant exposé par l’API, conservez une correspondance entre le périmètre du service, cet identifiant et la référence du système externe. Ajoutez, si cela est utile, le nom et le chemin observés, l’état de synchronisation et les dates de dernière vérification. Ces métadonnées facilitent le diagnostic d’un conflit, mais ne devraient pas remplacer la clé principale. Définissez également quel système est autorisé à modifier chaque attribut ; si les deux côtés peuvent renommer le même fichier, convenez d’une méthode pour résoudre les divergences.
Mettez à jour l’enregistrement après confirmation d’une réponse de création ou de modification, et pas seulement après l’envoi d’une requête. Si une opération échoue ou si son résultat est incertain en raison d’une coupure de connexion, marquez la correspondance pour réconciliation plutôt que de créer automatiquement un autre fichier. Faites en sorte que la répétition des tâches ne génère pas d’associations en double. Si vous recevez des webhooks, vérifiez quel événement le contrat décrit et comparez l’état avant de modifier la relation.
- Conservez le minimum d’éléments nécessaire à l’audit de l’association ; évitez d’enregistrer des identifiants de connexion ou des secrets à ses côtés.
- Définissez des états tels que « en attente », « actif », « introuvable » et « à vérifier », selon les besoins de votre intégration.
Tester les renommages, les déplacements et le cycle de vie
Préparez un test contrôlé avec un fichier de référence et consignez son identifiant, son nom, son chemin et la réponse à la requête de consultation. Renommez-le au moyen de l’opération documentée ou du processus prévu, consultez-le à nouveau et comparez les champs. Répétez le test avec un déplacement entre emplacements si le service le permet. L’objectif n’est pas de confirmer ce qui devrait se produire, mais de l’observer et de le comparer à une garantie écrite. Conservez le même enregistrement externe pendant l’essai afin de repérer si votre intégration le duplique.
Testez également la suppression et la recréation avec le même nom et le même emplacement. Vérifiez si la recherche renvoie l’ancienne ressource, une nouvelle, aucune ou plusieurs, et quelle erreur survient lorsque vous consultez la référence supprimée. Ne réutilisez pas automatiquement une correspondance au seul motif que le chemin est identique. Vérifiez que les cas couvrent les réponses tardives, les défaillances intermédiaires et les nouvelles tentatives, et conservez suffisamment de résultats pour reproduire le diagnostic.
- Cas minimaux : renommer, déplacer, supprimer, recréer avec le même nom et réessayer une opération interrompue.
- Critère de réussite : la relation externe pointe vers la bonne ressource, sans créer de doublon ni réassocier silencieusement un fichier.
S’il n’existe pas d’identifiant stable documenté
Si la spécification n’expose pas d’identifiant ou ne documente pas sa stabilité, n’inventez pas de garantie. Demandez au fournisseur quel est l’identifiant canonique, quelle est sa portée et quelles sont les règles applicables au renommage, au déplacement, à la copie et à la recréation. Dans l’intervalle, vous pouvez utiliser plusieurs indices pour trouver des candidats — par exemple le chemin, le nom et les attributs exposés par le service —, mais considérez le résultat comme une correspondance provisoire, et non comme une identité démontrée.
Pour résoudre les cas ambigus, suspendez la mise à jour automatique et envoyez l’enregistrement en révision ou en réconciliation. Comparer uniquement le nom et la taille, par exemple, risque de confondre deux fichiers légitimes ; une empreinte du contenu a également ses limites et ne remplace pas l’identité de la ressource. L’API File System Access (https://developer.chrome.com/docs/capabilities/web-apis/file-system-access?hl=es-419) permet aux applications Web d’interagir avec les fichiers de l’appareil de l’utilisateur, mais cela ne définit pas l’identité proposée par un service de stockage distant. Signalez explicitement l’incertitude.
- N’utilisez les correspondances approximatives que comme aide à la révision, jamais pour réassocier un fichier silencieusement.
- Documentez les changements nécessitant une intervention et les données requises pour les résoudre.
Liste de contrôle avant le déploiement
Avant d’activer une synchronisation, vérifiez que l’équipe peut expliquer d’où vient l’identifiant, dans quel périmètre il est valide et quelle opération le renvoie. Assurez-vous que la table de correspondance distingue l’identité des attributs modifiables, qu’une réponse en échec n’est pas confondue avec une suppression et que les changements non confirmés peuvent être réconciliés. Si vous utilisez Apification, vous pouvez intégrer Cloud et ses services au moyen d’API REST, d’OpenAPI et de webhooks ; cela ne remplace pas la vérification des règles propres à la ressource.
Enfin, effectuez les tests dans un espace contrôlé et définissez comment observer les erreurs : journaux contenant des identifiants non secrets, états de synchronisation et alertes en cas d’association ambiguë. Recommencez cette vérification lorsque la version de la spécification ou la logique de synchronisation change. La réussite ne se mesure pas à la concordance des noms, mais au fait que chaque référence externe mène à la ressource prévue ou échoue d’une manière visible et réversible.
- L’identifiant et son périmètre sont-ils documentés ?
- Les renommages, déplacements, suppressions et recréations ont-ils été testés ?
- Les erreurs et les correspondances ambiguës sont-elles visibles et récupérables ?
- L’intégration évite-t-elle de réassocier une ressource au seul motif qu’elle a le même nom ou le même chemin ?
Questions fréquentes
Puis-je utiliser le chemin comme identifiant de fichier dans une API ?
Uniquement si le contrat du service indique qu’il s’agit d’une référence adaptée à cet usage. Si le chemin peut changer, conservez-le comme attribut et vérifiez s’il existe un identifiant de ressource assorti de garanties documentées.
Un champ nommé id garantit-il que le fichier conserve son identité lorsqu’il est renommé ?
Non, pas à lui seul. La spécification doit préciser ce que le champ identifie, sa portée et son comportement en cas de renommage, de déplacement, de copie ou de recréation.
Que faire si l’API ne documente aucun identifiant stable ?
Demandez des précisions au fournisseur et considérez les correspondances fondées sur le nom ou le chemin comme provisoires. Évitez toute réassociation automatique en cas d’ambiguïté et mettez en place un processus de réconciliation.
Sources et lectures
Documentation consultée pour préparer cet article.
- Cambio de nombre de archivo (API REST) — Microsoft Learn
- Cómo buscar archivos y carpetas — Google for Developers
- API de File System Access — Google Chrome for Developers
Découvrez Apification
Articles associés
API et automatisation
Erreurs dans une API de fichiers : comment les diagnostiquer sans exposer de données ni répéter des actions à l’aveugle
Un guide pratique pour repérer à quelle étape une intégration de fichiers échoue, consigner des informations utiles sans révéler de données sensibles et décider s’il faut corriger, réessayer ou arrêter une opération.
API et automatisation
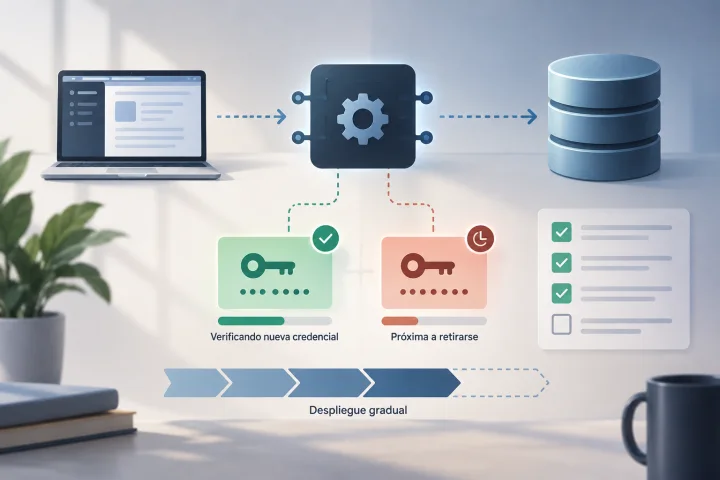
Comment renouveler des identifiants d’API sans laisser une intégration de fichiers inachevée
Un guide pour préparer, déployer, vérifier et retirer des identifiants d’API, avec des contrôles pour limiter les risques d’interruption des flux de fichiers.
API et automatisation
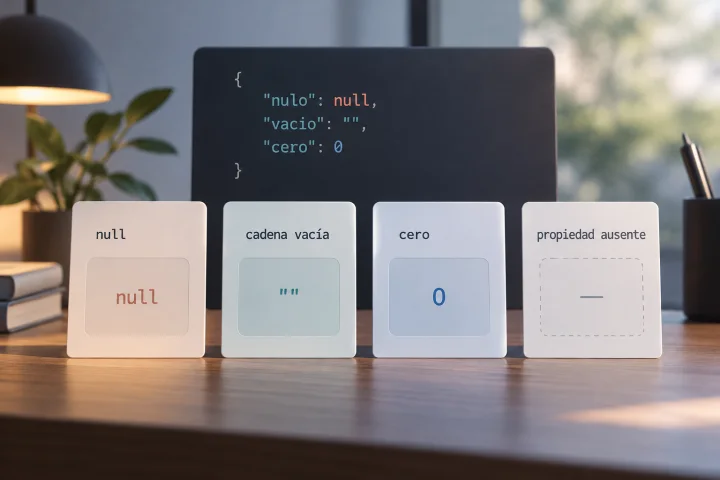
Null, chaîne vide, zéro ou champ absent : éviter les changements de sens en JSON pour une API
Distinguez les valeurs d’un payload JSON et consultez le contrat de l’API avant de décider comment transformer ou envoyer chacune d’elles.