API et automatisation
Erreurs dans une API de fichiers : comment les diagnostiquer sans exposer de données ni répéter des actions à l’aveugle
Un guide pratique pour repérer à quelle étape une intégration de fichiers échoue, consigner des informations utiles sans révéler de données sensibles et décider s’il faut corriger, réessayer ou arrêter une opération.
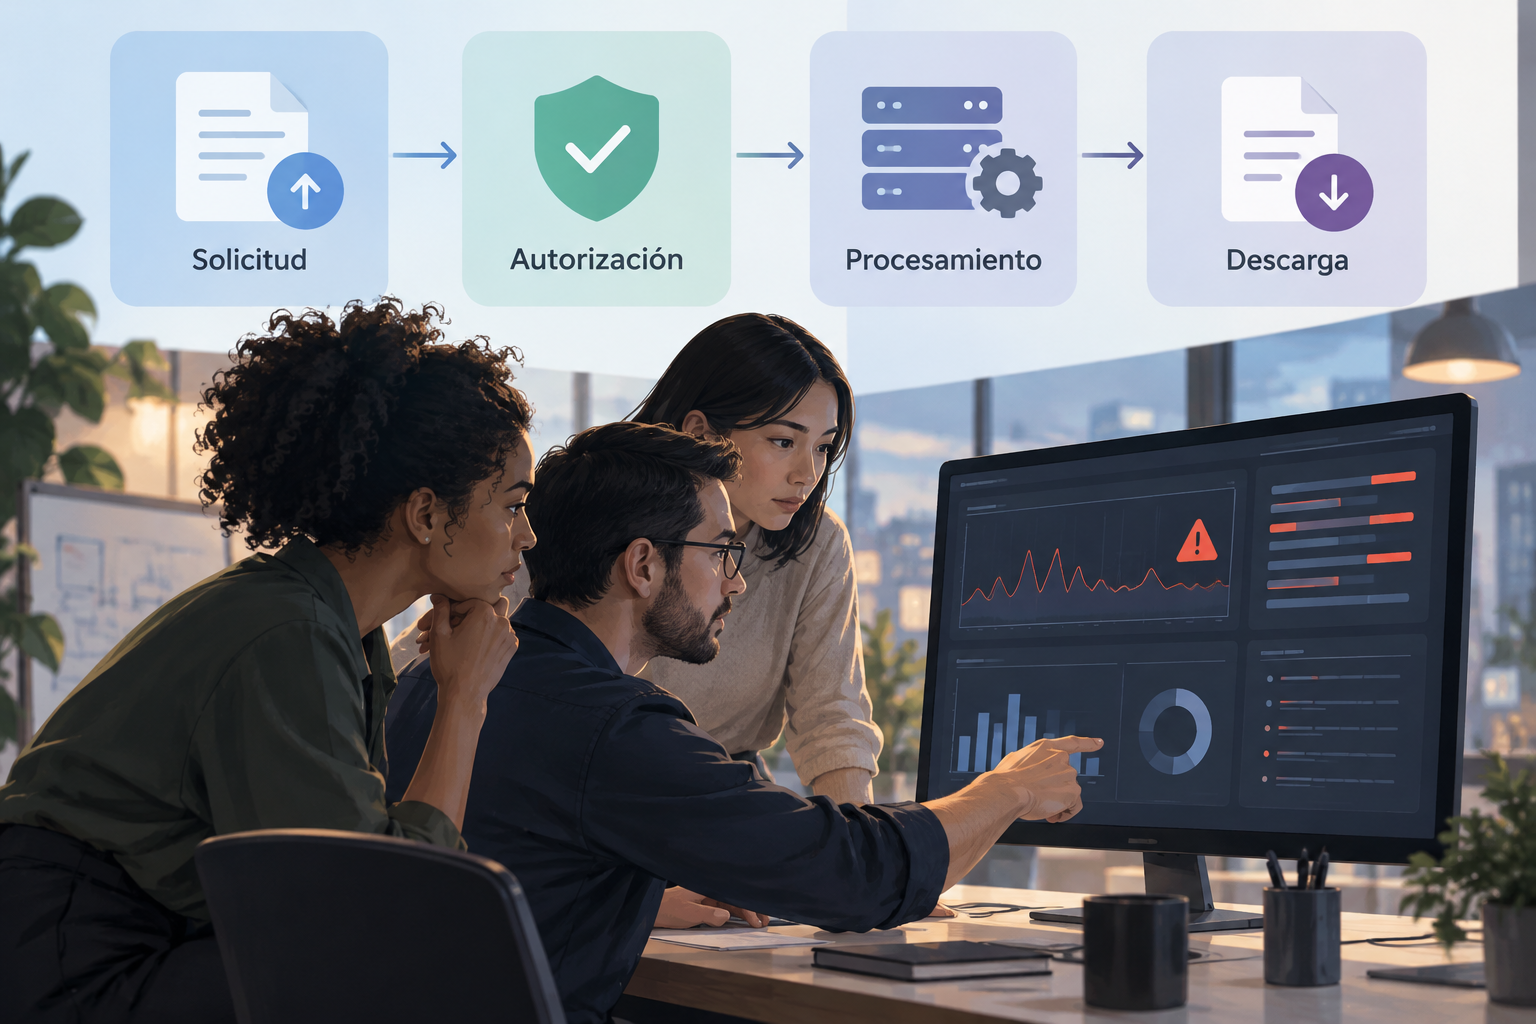
Pourquoi « le chargement a échoué » ne suffit pas au diagnostic
Un message générique confirme que quelque chose ne s’est pas déroulé comme prévu, mais n’indique pas où chercher. Le fichier n’a peut-être pas été envoyé, l’identité de l’intégration n’avait peut-être pas accès à la ressource, le traitement a peut-être échoué ou la réponse a peut-être été générée sans que le client puisse la télécharger. Si toutes ces situations aboutissent au même message, l’équipe essaie des solutions au hasard et risque de répéter des opérations qui ont déjà produit un effet.
Concevez le diagnostic pour répondre à trois questions : quelle action a été tentée, à quelle étape a-t-elle été interrompue et quels éléments permettent de le confirmer ? Par exemple, consignez qu’une demande de transformation a atteint l’étape de traitement et que le résultat n’a pas pu être récupéré, sans enregistrer le contenu du fichier. Cette description est plus utile qu’« erreur », mais ne prétend pas révéler une cause qui n’a pas encore été vérifiée. L’objectif initial est de circonscrire le problème, pas de le deviner.
- Remplacez « le chargement a échoué » par une description de l’étape et du type d’action.
- Séparez les faits observés des hypothèses sur la cause.
- Ne faites pas du message visible par l’utilisateur l’unique trace disponible pour l’assistance.
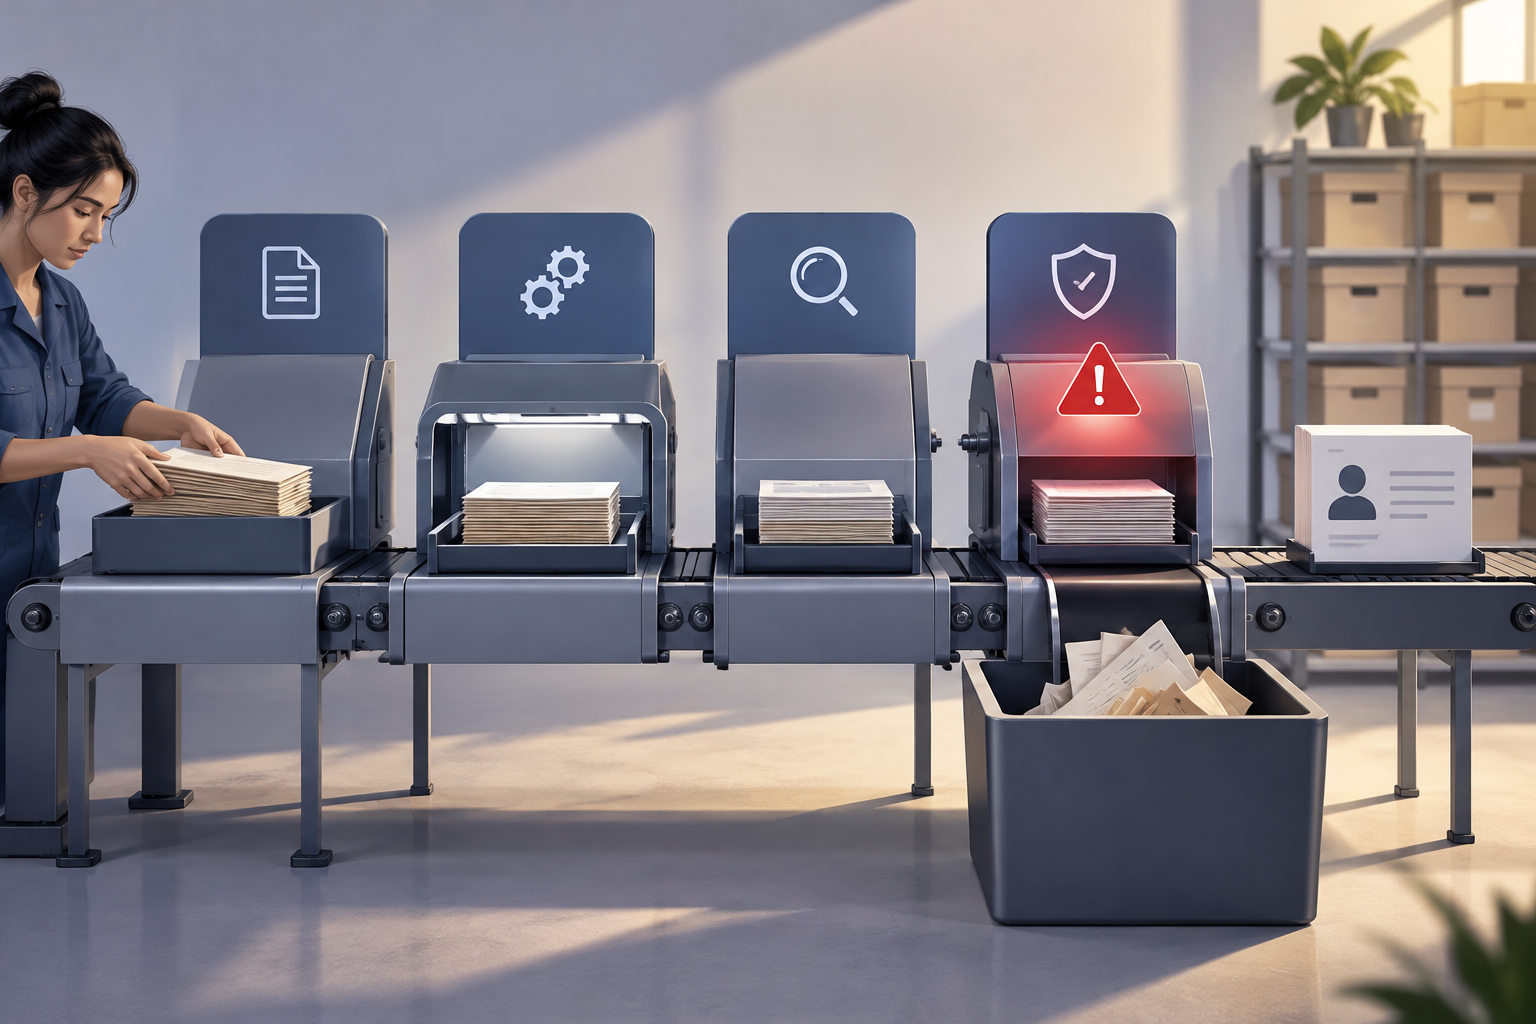
Décomposez le flux en étapes avant de chercher la cause
Divisez le parcours en demande, autorisation, traitement et livraison. Pour la demande, vérifiez que votre application construit la requête avec les champs exigés par le contrat, et que le fichier ainsi que les options correspondent aux attentes. Pour l’autorisation, vérifiez quelle identité est utilisée et si elle a accès à l’opération et à la ressource. Ne confondez pas une requête mal formée avec un manque d’autorisation : ce sont deux pistes d’investigation différentes.
Distinguez ensuite le traitement de la livraison. Une transformation peut ne pas aboutir ; il est également possible qu’un résultat existe, mais que le client ne parvienne pas à le récupérer ou à le télécharger. Consignez le dernier jalon confirmé et l’étape suivante qui n’a pas pu être vérifiée. Si Apification fait partie du flux, ses services s’intègrent au moyen d’API REST, d’OpenAPI et de webhooks. Consultez la documentation applicable pour comprendre les signaux exposés par chaque interface, plutôt que de supposer qu’elles fournissent toutes les mêmes informations.
- Notez l’étape, l’opération ainsi que les heures de début et de fin, avec une référence interne non sensible.
- Identifiez le composant qui a confirmé le dernier jalon et celui qui devait intervenir ensuite.
- Testez chaque segment séparément lorsque la conception de l’intégration le permet.
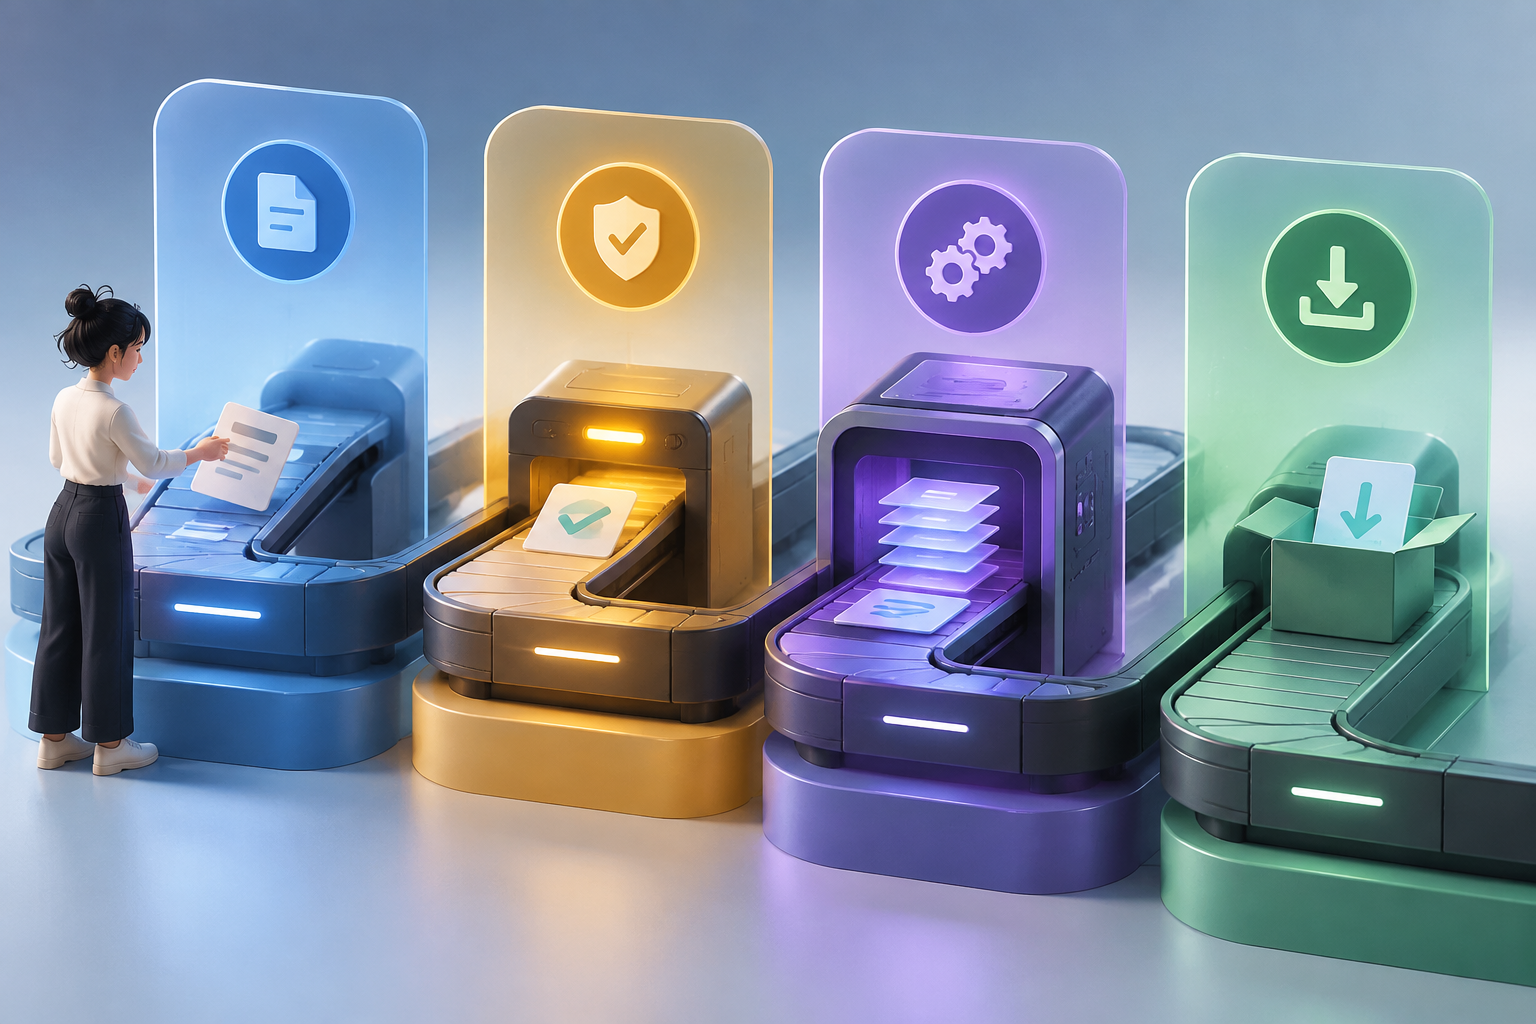
Classez l’échec avant de modifier ou de répéter l’opération
Une classification simple évite de confondre des problèmes différents. Prenez au moins en compte les catégories suivantes : entrée invalide ou incomplète ; autorisation insuffisante ; dépendance temporairement inaccessible ; et résultat incertain, lorsque vous ne pouvez pas confirmer si l’opération a produit des changements. Ajoutez une catégorie distincte pour les échecs de livraison. Il s’agit de pistes d’investigation, pas de codes universels : une API précise peut utiliser d’autres noms, états ou distinctions, qu’il convient de vérifier dans sa documentation.
Associez chaque catégorie à une vérification, et non à une action automatique. Pour une entrée, validez le format et les champs obligatoires avant l’envoi. Pour les autorisations, vérifiez l’identité, le périmètre et l’accès effectif à la ressource. En cas de dépendance temporaire, vérifiez s’il existe des signes de rétablissement avant de décider de la suite. Si le résultat est incertain, interrompez les répétitions jusqu’à ce que l’état puisse être rapproché. Vous éviterez ainsi de traiter chaque erreur comme temporaire ou d’accuser les autorisations sans preuve.
- Consignez une catégorie provisoire et un niveau de confiance, puis mettez-les à jour lorsque de nouveaux éléments apparaissent.
- Conservez « cause inconnue » comme option valide.
- Ne déduisez pas la catégorie d’échec d’un simple message de réponse succinct.
Les messages utiles et les journaux sécurisés ont des fonctions différentes
Le message destiné à la personne qui utilise le système doit expliquer ce qu’elle peut faire : vérifier les données, demander un accès ou contacter l’assistance en fournissant une référence d’incident. Évitez d’afficher des détails internes, des chemins privés, le contenu du fichier, des identifiants ou des traces complètes. La personne a besoin d’une instruction compréhensible, pas d’une réponse technique non filtrée. Si la cause n’est pas encore connue, dites-le clairement au lieu d’attribuer le problème à un manque d’autorisation ou à une panne.
Le journal technique doit contenir assez de contexte pour reconstituer le parcours, mais pas le fichier lui-même. Un exemple de journal sécurisé pourrait inclure : la date et l’heure, l’action « transformer », l’étape « livraison », l’environnement, le résultat observé et une référence de corrélation opaque. N’incluez ni jetons, ni clés, ni données personnelles inutiles, ni noms de fichiers sensibles, ni corps complets de requêtes. Définissez qui peut consulter les journaux et combien de temps ils sont conservés, conformément aux règles de votre organisation.
- Exemple de journal : « action=transformer ; étape=livraison ; référence=opaque ; résultat=non confirmé ».
- Supprimez ou masquez les secrets et les données qui ne sont pas nécessaires au diagnostic.
- Vérifiez que les messages, les traces et les outils d’assistance ne divulguent pas les mêmes données par une autre voie.
Interprétez les états et les erreurs selon le contrat de l’API
Il n’existe pas de tableau d’erreurs universel applicable à toutes les API. La documentation Google de son API Indexing définit des codes et des messages propres à ce service ; cela ne transforme pas ces réponses en règles pour une API de fichiers. De la même manière, un guide de dépannage consacré à une API donnée aide à interpréter cette API, mais ne permet pas de déduire le comportement d’une autre. Ces ressources montrent pourquoi chaque intégration nécessite de consulter sa source primaire.
Avant d’implémenter des décisions automatiques, repérez dans le contrat les opérations disponibles, les entrées qu’elles exigent ainsi que la façon dont leurs résultats et erreurs sont décrits. Vérifiez également si la documentation définit des conditions de répétition ou d’identification des requêtes. Si le contrat ne répond pas à une question, n’inventez pas une signification à partir du texte de l’erreur : conservez les éléments disponibles, évitez les actions risquées et consultez le responsable du service. Documentez la version ou la référence du contrat utilisée par l’équipe.
- Consultez la documentation officielle de l’API et de l’opération concernées.
- Vérifiez si les états, les messages et les conditions de nouvelle tentative sont définis pour cette opération.
- Considérez toute correspondance locale entre erreurs comme une interprétation documentée et révisable.
Décidez s’il faut corriger, réessayer ou s’arrêter
Corrigez le problème lorsque les éléments disponibles indiquent une entrée incorrecte ou une autorisation à ajuster ; validez ensuite la modification avant de renvoyer la demande. Une nouvelle tentative n’est raisonnable que si la documentation et l’état observé permettent de procéder en toute sécurité. Si l’API documente des mécanismes permettant d’identifier les demandes répétées ou de consulter le résultat précédent, intégrez-les. Ne supposez pas qu’une opération est idempotente ni qu’un échec de communication signifie que le serveur n’a rien fait.
Arrêtez-vous lorsque le résultat est incertain, lorsque la répétition risque de dupliquer une conversion, une publication ou une modification, ou lorsqu’il existe un risque d’accès indu. Conservez la référence de la tentative et cherchez à confirmer l’état avant d’entreprendre une autre action. Si l’API documente des nouvelles tentatives pour des webhooks ou des actions précises, respectez ces conditions ; ne les extrapolez pas à d’autres points de terminaison. Dans Apification, les automatisations par API et webhooks comprennent des nouvelles tentatives, un historique et des statistiques, mais l’intégration doit respecter le comportement documenté pour chaque action.
- Corriger : une cause vérifiable concerne les données ou les autorisations.
- Réessayer : le contrat le permet et l’état précédent est suffisamment clair.
- S’arrêter : l’opération a peut-être été appliquée et vous ne pouvez pas en confirmer le résultat.
Testez les échecs et reconstituez les incidents à partir des éléments disponibles
Ajoutez des tests négatifs au parcours normal. Vérifiez ce qui se passe avec une entrée incomplète, une identité dépourvue de l’autorisation nécessaire, une dépendance temporairement indisponible et un téléchargement qui n’aboutit pas. Pour chaque cas, contrôlez le message affiché, les informations consignées et la décision prise par le client. Les cas doivent correspondre à ce que l’environnement de test permet réellement de simuler ; ne forcez pas d’opérations susceptibles d’affecter des fichiers de production.
Un test utile permet de reconstituer la séquence sans exposer le contenu : demande lancée, étape atteinte, erreur observée, décision automatique ou manuelle et état final confirmé. Vérifiez que deux tentatives liées peuvent être distinguées et que les références ne révèlent pas d’identifiants internes à des utilisateurs non autorisés. Si des versions de fichiers sont utilisées, Apification Cloud permet de consulter l’historique, de télécharger des versions antérieures et de restaurer du contenu ; cette capacité peut aider à récupérer un état antérieur, mais ne remplace pas la vérification de l’opération qui a échoué.
- Testez séparément les échecs liés à l’entrée, à l’accès, au traitement et à la livraison.
- Vérifiez que les actions ne sont pas répétées sans décision explicite et traçable.
- Assurez-vous que l’équipe peut suivre l’incident sans consulter de secrets ni de contenu sensible.
Liste de contrôle pour une intégration diagnostiquable et sécurisée
Avant de déployer une intégration, vérifiez que chaque opération comporte une étape identifiable et que le client distingue une correction d’une répétition. Assurez-vous que le contrat officiel est accessible aux personnes qui maintiennent le code et que les décisions automatiques sont justifiées par une documentation. Vérifiez également les autorisations utilisées par l’intégration : accorder plus d’accès que nécessaire peut transformer un problème de configuration en exposition de fichiers.
Enfin, répétez la procédure d’assistance à partir d’un incident de test. Une personne doit pouvoir expliquer ce qui a été tenté, ce qui a été confirmé, ce qui reste incertain et quelle est la prochaine étape sûre, en n’utilisant que les journaux autorisés. Apification propose des fonctionnalités de gestion et de partage de fichiers dans Cloud, ainsi que des options d’intégration ; la sécurité du flux concret dépend aussi de la configuration des autorisations, des contrôles et de la gestion des erreurs. Tenez cette liste à jour lorsque le contrat ou le parcours change.
- Chaque erreur indique l’étape et une référence de corrélation non sensible.
- Les messages destinés aux utilisateurs les orientent sans révéler de détails internes.
- Les journaux ne contiennent ni identifiants, ni contenu, ni données personnelles inutiles.
- Les codes et les états sont interprétés à partir de la documentation de l’API concernée.
- Les nouvelles tentatives dépendent du contrat et du degré de certitude concernant le résultat.
- Les cas d’erreur sont testés et l’équipe peut reconstituer un incident.
Questions fréquentes
Puis-je utiliser les mêmes codes d’erreur pour toutes les API de fichiers ?
Non. Les codes, les messages et leur signification dépendent de l’API et de l’opération. Consultez le contrat et la documentation officielle du service intégré ; ne transposez pas le tableau d’une autre API.
Quand est-il préférable de réessayer une opération sur un fichier ?
Uniquement lorsque la documentation applicable autorise une nouvelle tentative et que vous pouvez évaluer l’état de la tentative précédente. Si vous ignorez si le fichier a déjà été traité ou modifié, arrêtez-vous et confirmez le résultat avant d’agir à nouveau.
Quelles données un journal d’erreur sécurisé devrait-il contenir ?
Incluez le type d’action, l’étape, un horodatage, le résultat observé et une référence de corrélation qui ne révèle pas d’informations internes. Excluez les identifiants, le contenu du fichier et les données personnelles qui ne sont pas nécessaires.
Sources et lectures
Documentation consultée pour préparer cet article.
- Lista de errores de la API de Indexing — Google for Developers
- Solucionar problemas de la API multivariante — Microsoft Learn
- Solución de errores y latencia de la API — OpenAI Help Center
Découvrez Apification
Articles associés
API et automatisation
Comment renouveler des identifiants d’API sans laisser une intégration de fichiers inachevée
Un guide pour préparer, déployer, vérifier et retirer des identifiants d’API, avec des contrôles pour limiter les risques d’interruption des flux de fichiers.
API et automatisation
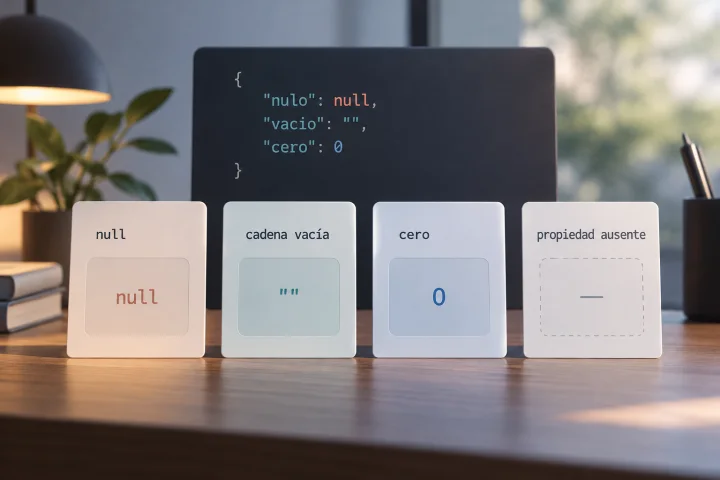
Null, chaîne vide, zéro ou champ absent : éviter les changements de sens en JSON pour une API
Distinguez les valeurs d’un payload JSON et consultez le contrat de l’API avant de décider comment transformer ou envoyer chacune d’elles.
API et automatisation
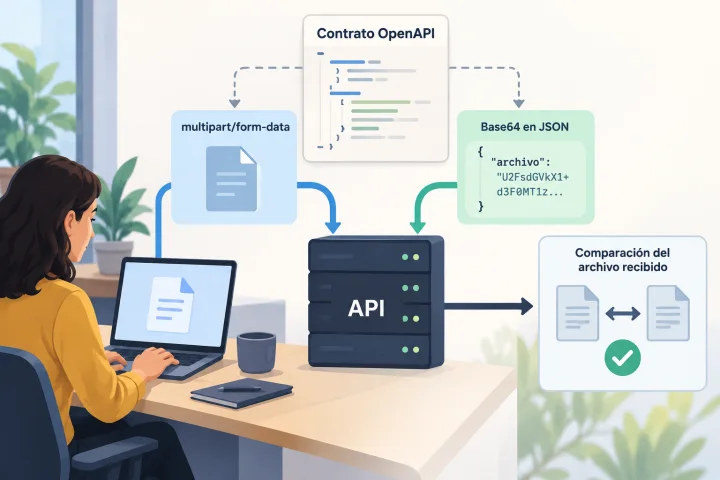
Envoyer des fichiers à une API : multipart ou Base64 et éviter les transferts corrompus
La représentation appropriée dépend du contrat de chaque endpoint. Apprenez à l’examiner, à construire des requêtes compatibles et à vérifier le fichier reçu avant de mettre l’intégration en production.