Documents et données
Convertir un JSON imbriqué en CSV : aplatir les données sans en perdre le sens
Apprenez à choisir les nœuds de ligne, à aplatir les objets et à définir des règles pour les tableaux. Suivez des exemples conceptuels, comparez différentes structures possibles et vérifiez l’aperçu du CSV.
Ce qu’il faut décider pour convertir un JSON imbriqué en CSV
JSON peut contenir des objets imbriqués et des tableaux ; le CSV organise les informations en lignes et en colonnes. Pour passer d’une structure à l’autre, vous devez décider quel élément représente une ligne et quels champs deviendront des colonnes. La conversion ne consiste pas simplement à changer l’extension : elle implique aussi de choisir comment représenter les données qui ne s’intègrent pas directement dans un tableau plat.
L’outil de Datablist permet de sélectionner des nœuds de ligne, de choisir des objets à aplatir, de définir des règles pour les tableaux et de prévisualiser le CSV avant de le télécharger. Ces fonctions permettent de configurer la conversion, mais le résultat précis dépend de vos choix. Ne tenez pas pour acquis les noms des colonnes ni la représentation de chaque champ sans vérifier la configuration et l’aperçu.
Avant de commencer, examinez la structure du JSON et repérez l’objet ou l’ensemble d’objets qui contient les enregistrements qui vous intéressent. Identifiez ensuite les informations dont vous avez besoin dans le tableau final. Un fichier peut inclure des champs inutiles pour votre objectif d’exportation ; décider lesquels conserver fait partie de la conception pratique, et ce n’est pas une propriété automatique du format CSV.
- Décidez quel nœud du JSON représente chaque ligne.
- Choisissez les objets imbriqués que vous souhaitez aplatir.
- Définissez une règle pour les tableaux et vérifiez l’aperçu.
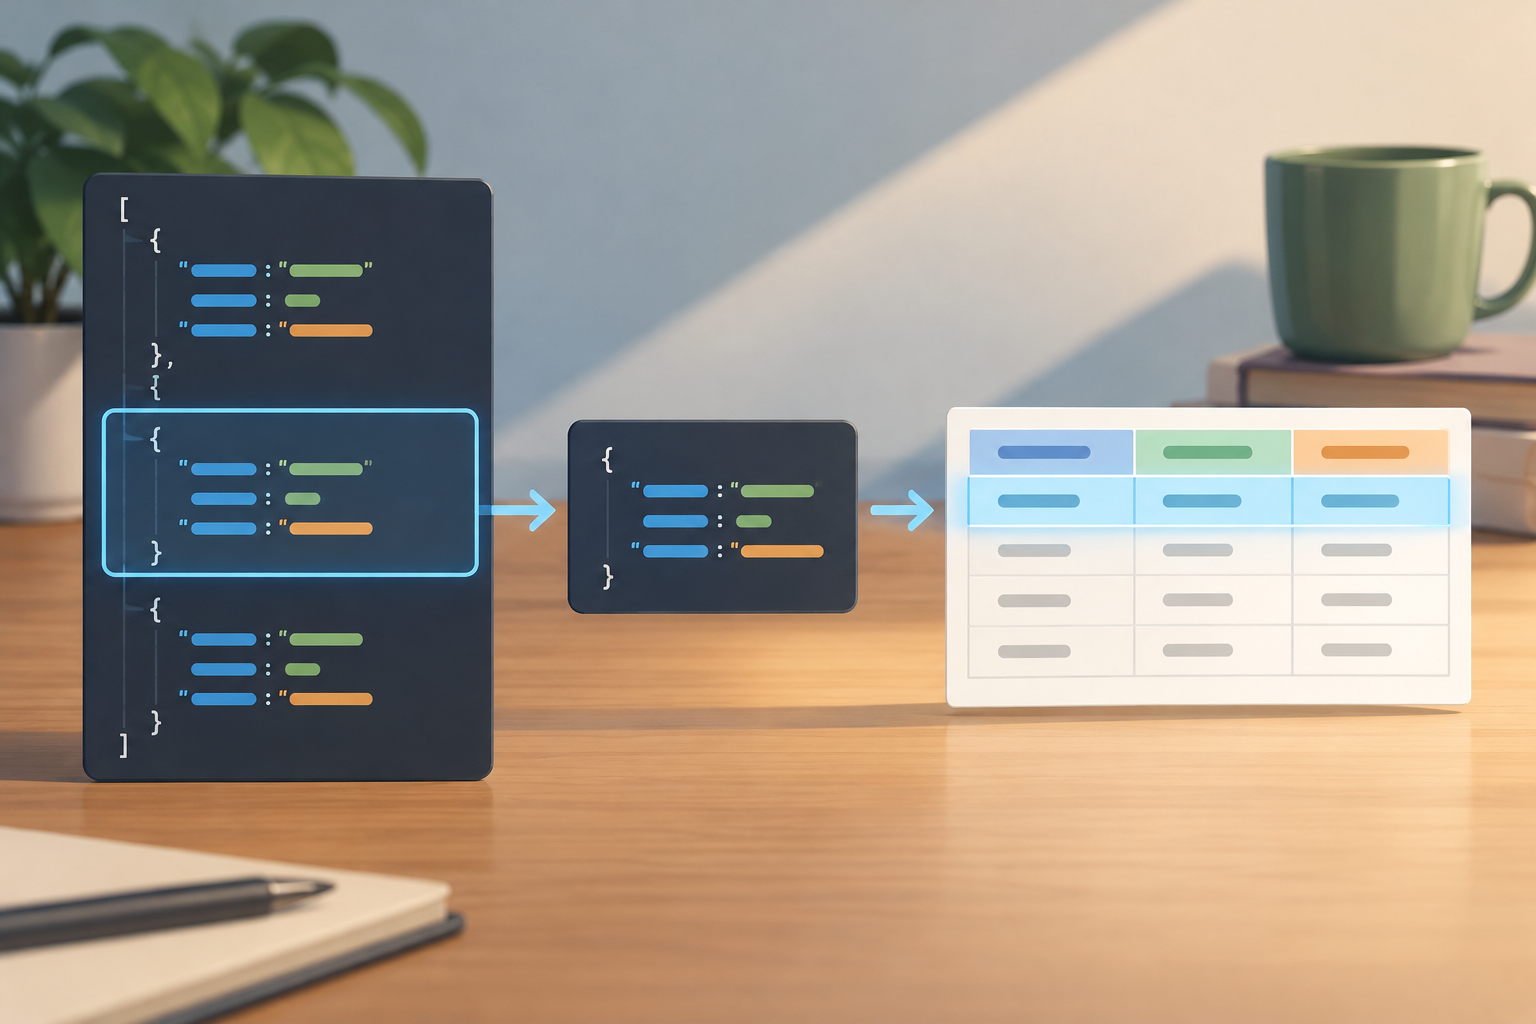
Exemple : aplatir un objet imbriqué
Prenons cet exemple hypothétique : chaque commande représente une ligne, et les champs de l’objet « client » deviennent des colonnes. L’entrée ne contient qu’une seule commande afin d’illustrer clairement ce que signifie aplatir un objet : choisir des champs situés dans un autre objet et les représenter dans les colonnes du tableau.
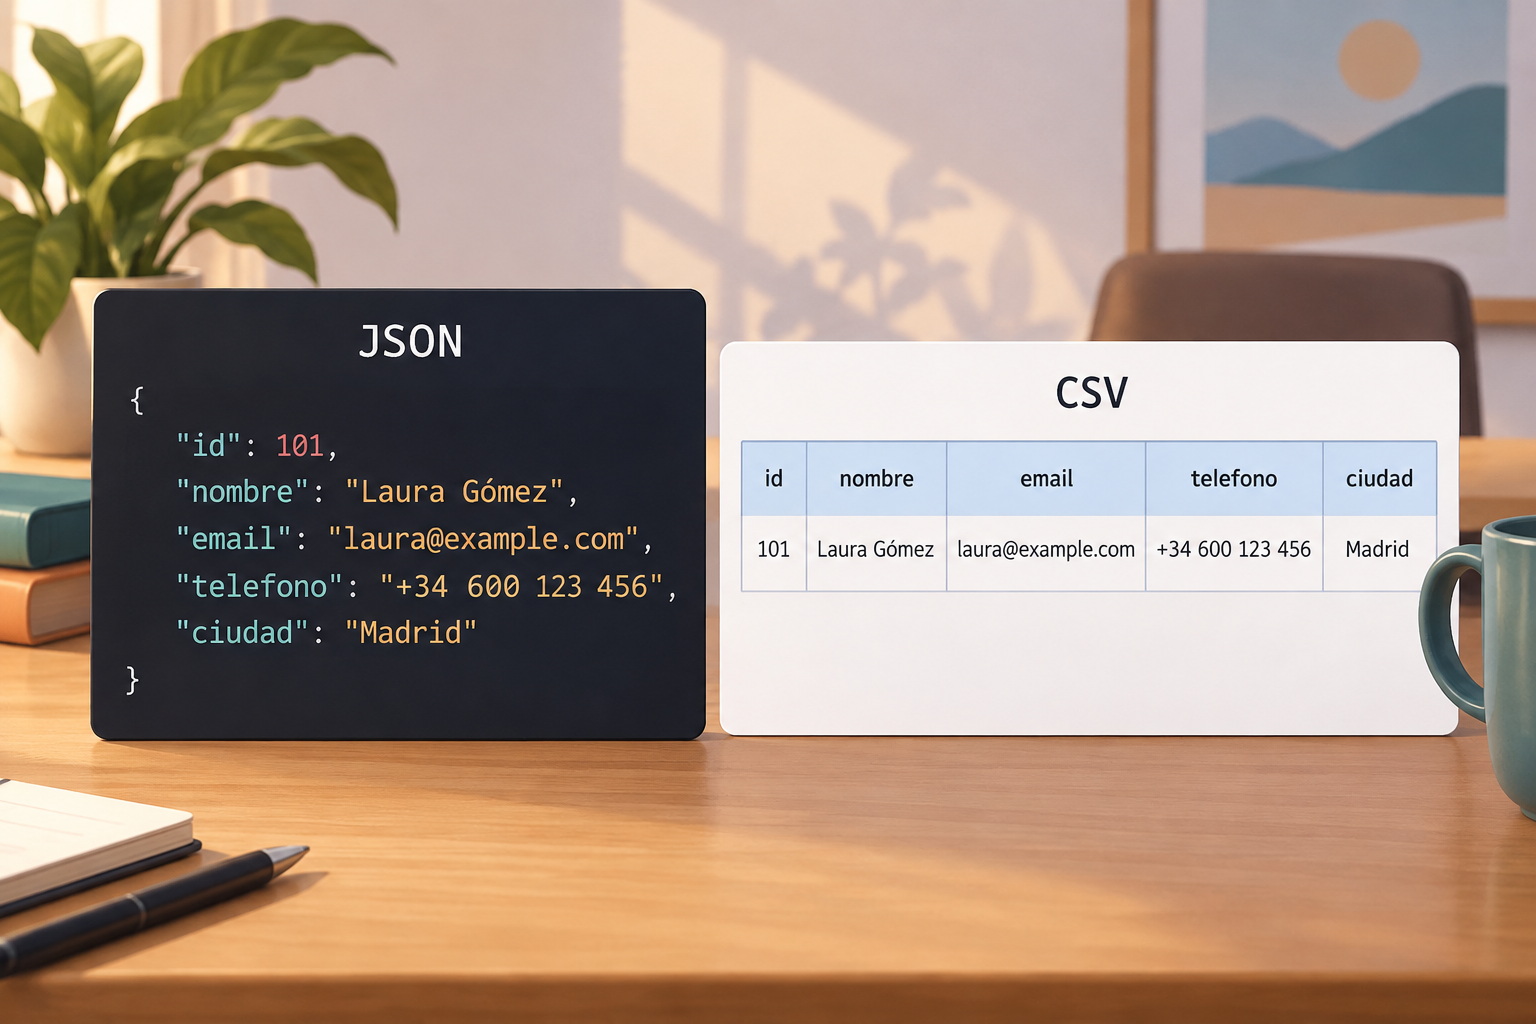
JSON en entrée : {"commande_id": "P-104", "client": {"nom": "Lucía", "ville": "Sevilla"}, "total": 48.5}
Une représentation CSV possible pour ce choix serait : commande_id,client_nom,client_ville,total P-104,Lucía,Sevilla,48.5
Dans cette proposition, client_nom et client_ville indiquent quels champs de l’objet client ont été intégrés au tableau. Ces noms sont donnés à titre d’exemple : les sources citées ne les présentent pas comme une convention de Datablist et ils ne garantissent pas la manière dont un autre outil nommera les colonnes. Si vous avez besoin d’en-têtes dans un format précis, vérifiez-les dans l’aperçu.
Ce choix change les informations qu’il est facile de consulter dans le tableau. Si vous aplatissez les champs dont vous avez besoin, vous pouvez les voir dans des colonnes distinctes ; si vous choisissez une autre structure ou que vous laissez un objet sans l’aplatir, la représentation peut ne pas correspondre au tableau attendu. Il est donc préférable de comparer les en-têtes et les valeurs de l’aperçu aux champs d’origine, plutôt que de supposer que l’exemple détermine le résultat de votre conversion.
Comment envisager les tableaux : deux représentations possibles
Les tableaux nécessitent une règle de conversion. Datablist indique que son convertisseur permet de définir des règles pour les tableaux, mais les éléments disponibles ne précisent pas comment il traite des cas concrets, comme les tableaux de longueurs différentes ou les tableaux vides. L’exemple suivant est un modèle conceptuel qui montre pourquoi il est utile de décider de la forme tabulaire ; il ne décrit pas des options ni des résultats garantis de Datablist.
Supposons qu’une commande comporte deux étiquettes : « urgente » et « cadeau ». Une représentation illustrative pourrait réserver des colonnes selon la position, comme etiquette_1 et etiquette_2, et conserver la commande sur une seule ligne. Une autre représentation conceptuelle pourrait consacrer une ligne à chaque étiquette, en répétant l’identifiant de la commande : P-104 avec « urgente » sur une ligne, et P-104 avec « cadeau » sur une autre. Aucun de ces exemples n’affirme que le convertisseur génère automatiquement ces structures.
Ces solutions entraînent des conséquences visibles. Dans l’exemple, une ligne avec des colonnes par position regroupe les données de la commande ; toutefois, si un autre enregistrement contient plus d’éléments que le nombre de positions représentées, il faudra décider comment les intégrer. Une ligne par élément permet d’afficher chaque étiquette séparément dans l’exemple, mais répète la donnée qui identifie la commande. Il s’agit de conséquences de la conception de ces tableaux hypothétiques, et non d’une description du comportement d’un outil précis.
Lors d’une conversion réelle, ne supposez pas que la règle disponible produira l’une de ces formes — ou une autre. Examinez l’aperçu avec un exemple qui contient un tableau avec des éléments et comparez-le au JSON source. Si la longueur des tableaux varie dans vos données, incluez plusieurs cas dans la vérification. Les sources citées ne documentent pas le traitement des tableaux vides, des champs absents ou des valeurs nulles ; vérifiez le résultat de ces cas avec la configuration choisie.
- Considérez les représentations de l’exemple comme des schémas possibles, et non comme des résultats attribués à Datablist.
- Vérifiez l’aperçu à l’aide de tableaux représentatifs de vos données.
- Vérifiez séparément les cas que la documentation disponible ne précise pas.
Méthodes citées pour convertir du JSON en CSV avec Python
Bright Data cite les bibliothèques csv, json et pandas comme méthodes de conversion de données JSON en CSV avec Python, et indique que chaque méthode présente des avantages. Les éléments disponibles ici ne détaillent pas ces différences et ne prescrivent pas d’implémentation précise ; ils ne suffisent donc pas à affirmer qu’une bibliothèque est la meilleure pour une structure donnée.
Pour choisir une méthode, commencez par décrire la structure du fichier et le résultat tabulaire dont vous avez besoin : quel élément constituera une ligne, quels champs doivent devenir des colonnes et quelle décision vous avez prise pour les tableaux. Consultez ensuite la documentation de la méthode pour confirmer ses options et son comportement avec cette structure.
Ne supposez pas qu’une règle d’un convertisseur visuel s’applique de la même façon à une bibliothèque Python, ni que les trois bibliothèques citées produisent des résultats identiques. Si vous comparez des méthodes, utilisez le même JSON de test et examinez les tableaux obtenus selon les mêmes critères. Cette comparaison vous aide à vérifier si les en-têtes et les lignes correspondent à la structure recherchée, sans attribuer de capacités précises que les sources disponibles ne confirment pas.
Prévisualiser et vérifier la conversion
La prévisualisation fait partie des options décrites pour le convertisseur de Datablist. Utilisez-la pour vérifier si la sélection des nœuds, l’aplatissement des objets et les règles appliquées aux tableaux produisent un tableau conforme à vos attentes avant le téléchargement du CSV. Cette vérification ne remplace pas une définition claire de la structure : elle permet de comparer le résultat visible à vos choix.
Une vérification utile consiste à suivre un ou plusieurs enregistrements du JSON jusqu’à l’aperçu. Repérez la valeur d’origine, vérifiez quelle ligne et quelle colonne la représentent, et assurez-vous que les en-têtes correspondent aux champs que vous souhaitiez inclure. Pour un objet imbriqué, vérifiez les champs que vous avez aplatis ; pour un tableau, observez sa représentation effective sans la déduire d’un autre exemple.
Si le résultat ne conserve pas la structure attendue, revenez à vos décisions initiales : vous avez peut-être sélectionné un autre nœud de ligne, omis d’aplatir l’objet pertinent ou choisi une règle pour le tableau qui ne produit pas la forme envisagée. Si des champs sont absents ou si des valeurs sont nulles, ne présumez pas de la façon dont l’outil les interprète : les éléments disponibles ne documentent pas ce comportement. Vérifiez ces cas avec la configuration choisie avant d’utiliser le fichier.
Pour garder le fichier d’origine et les résultats de travail organisés, Apification Cloud propose un espace de travail versionné et permet de consulter l’historique des éléments. Cela peut aider à retrouver les versions des fichiers de travail ; cela ne valide pas la conversion et ne remplace pas la vérification du contenu du CSV.
- Vérifiez les en-têtes et suivez quelques valeurs du JSON jusqu’à l’aperçu.
- Incluez dans votre vérification des objets imbriqués et des tableaux représentatifs de la structure réelle de vos données.
- Si le résultat ne correspond pas à vos attentes, vérifiez la sélection et la règle avant le téléchargement.
- Veillez à pouvoir retrouver le JSON source et le CSV de travail.
Sources techniques consultées
Datablist, « Convertisseur JSON vers CSV » : https://www.datablist.com/es/tools/json-to-csv. Les éléments disponibles décrivent la sélection des nœuds de ligne, l’aplatissement des objets, les règles pour les tableaux et la prévisualisation avant le téléchargement.
Bright Data, « Comment convertir des données JSON en CSV avec Python ? » : https://brightdata.es/faqs/json/convert-json-data-to-csv. Les éléments disponibles citent les bibliothèques csv, json et pandas.
Les exemples de tableaux de ce guide sont donnés à titre illustratif. Les sources citées ne documentent ni convention précise de nommage des colonnes, ni traitement exact des tableaux de longueurs différentes, des tableaux vides, des champs absents ou des valeurs nulles.
Questions fréquentes
Que dois-je décider avant de convertir un JSON imbriqué en CSV ?
Définissez quel nœud représente une ligne, quels objets vous souhaitez aplatir et quelle règle vous appliquerez aux tableaux. Datablist propose des options pour ces choix ainsi qu’un aperçu du CSV.
Comment représenter un objet imbriqué dans un CSV ?
Vous pouvez choisir d’aplatir ses champs en colonnes. Par exemple, dans une représentation illustrative, les champs client.nom et client.ville peuvent apparaître sous les noms client_nom et client_ville.
Comment traiter les tableaux de longueurs différentes ou les valeurs nulles ?
Les informations techniques disponibles ne précisent pas le comportement de chaque convertisseur dans ces cas. Vérifiez la configuration et l’aperçu avec des données comprenant les cas présents dans votre fichier.
Quelles bibliothèques Python sont citées pour convertir du JSON en CSV ?
Bright Data cite csv, json et pandas. Consultez la documentation de la méthode choisie pour connaître ses options et son comportement avec votre structure de données.
Sources et lectures
Documentation consultée pour préparer cet article.
- Convertidor de JSON a CSV — Datablist
- ¿Cómo convertir datos JSON a CSV en Python? — Bright Data
Découvrez Apification
Articles associés
Documents et données
Fusionner des PDF avec des formulaires interactifs : vérifier les champs avant le partage
Un guide pratique pour repérer les champs remplissables, préparer les fichiers, fusionner des copies et tester le résultat avant de le distribuer.
Documents et données
Polices remplacées dans un document : détecter les changements de mise en page et préparer une livraison fiable
Un guide pratique pour examiner les alertes de polices, comparer la mise en page et décider quels fichiers livrer sans perdre l’original modifiable.
Documents et données
Partager un tableur modifiable sans casser les formules ni les rapports
Organisez la saisie, les calculs et les rapports avant de partager un tableur. Apprenez à coordonner les modifications, à tester les formules et à récupérer une version antérieure en cas de problème.